6. Resiliencia, performance y escalabilidad
Conclusión. El pico 10x de lecturas no llega al legado: se resuelve desde Redis, con cuotas por partner que impiden que uno consuma la capacidad de todos. Lo que sí llega al legado pasa por adaptadores con límite de concurrencia, circuit breaker y Kafka como amortiguador. Los fallos asíncronos se reintentan con espera creciente y terminan en colas de fallidos con alerta. En el demo, con el pico 10x, el p95 de stock y precio queda en 1,6 ms sin errores y las llamadas al ERP no crecen; con el ERP caído, las lecturas siguen respondiendo (sección 6.8).
6.1 Rate limiting por partner y canal
Dos niveles:
| Nivel | Dónde | Qué limita | Contador |
|---|---|---|---|
| 1. Tope general | KrakenD | Total por endpoint y un máximo igual para cualquier cliente | En memoria de cada instancia |
| 2. Cuota por partner | Envoy (rate limit global de la malla) | Por partner_id, nivel y grupo de rutas |
Compartido en Redis |
Cuotas iniciales por nivel, en peticiones por segundo:
| Nivel | Lecturas (stock y precio) | Órdenes | Uso previsto |
|---|---|---|---|
bronze |
20 | 2 | Partner nuevo o en pruebas |
silver |
100 | 10 | Marketplace mediano |
gold |
500 | 50 | Marketplace principal, e-commerce propio |
- La cuota es por partner; si un partner tiene varios canales, comparten cuota salvo que su política diga otra cosa.
- Al exceder:
429 RATE_LIMITEDconRetry-Aftery cabecerasRateLimit-*. - Las órdenes tienen cuota separada de las lecturas: un pico de consultas no deja a un partner sin poder vender.
- Si el servicio de cuotas falla, se deja pasar (fail open) y queda el tope general del gateway.
Trade-off: dos lugares donde se configuran límites y un servicio de cuotas más que operar. Se eligió así porque KrakenD comunitario no tiene cuotas por partner (sección 3.4). Riesgo de construcción declarado: si el rate limit global de Envoy se complica, el plan B es un filtro de cuota en la plantilla de servicio con el mismo contador en Redis.
6.2 Cache: dónde, qué, TTL e invalidación
| Dónde | Qué | TTL (time to live, vigencia) | Invalidación |
|---|---|---|---|
| Redis (modelo de lectura) | Stock, precio, producto, segmento | Sin vencimiento funcional; TTL de seguridad de 24 horas (stock) y 7 días (precio) | Por evento: cada cambio reescribe la llave |
| Gateway (microcache) | Respuestas de GET /v1/stock y GET /v1/prices, por partner y consulta |
2 segundos, solo en modo promo | Por tiempo |
| Sidecar y gateway | JWKS de Keycloak | 10 minutos | Por tiempo, con refresco ante llave desconocida |
| pricing-service | Política de canal y listas de precios | 60 segundos en memoria | Por tiempo |
No se cachea el estado de órdenes, las reservas ni nada de la ruta de crear orden.
El modelo de lectura no es una cache por vencimiento: es una vista materializada que se actualiza por evento, y la invalidación es el evento mismo. Se descartó la cache con vencimiento delante del legado porque cada vencimiento vuelve a golpearlo, y una avalancha de fallos de cache en plena promo lo tumba igual. Los tópicos de estado de Kafka son compactados (conservan el último valor por llave), así que reconstruir Redis desde cero es releerlos.
Frescura prometida, como objetivo de diseño:
| Dato | Frescura objetivo (p95) | Umbral de stale: true |
|---|---|---|
| Stock | 10 segundos desde el cambio en el WMS | 5 minutos |
| Precio | 60 segundos desde el cambio en el ERP | 30 minutos |
Trade-off: el dato puede estar levemente desactualizado. Se acepta porque se declara (asOf, stale), se mide, y porque la decisión que importa, prometer la unidad, no se toma con este dato sino con la reserva.
6.3 Flujo B: consulta masiva en promo, antes y después
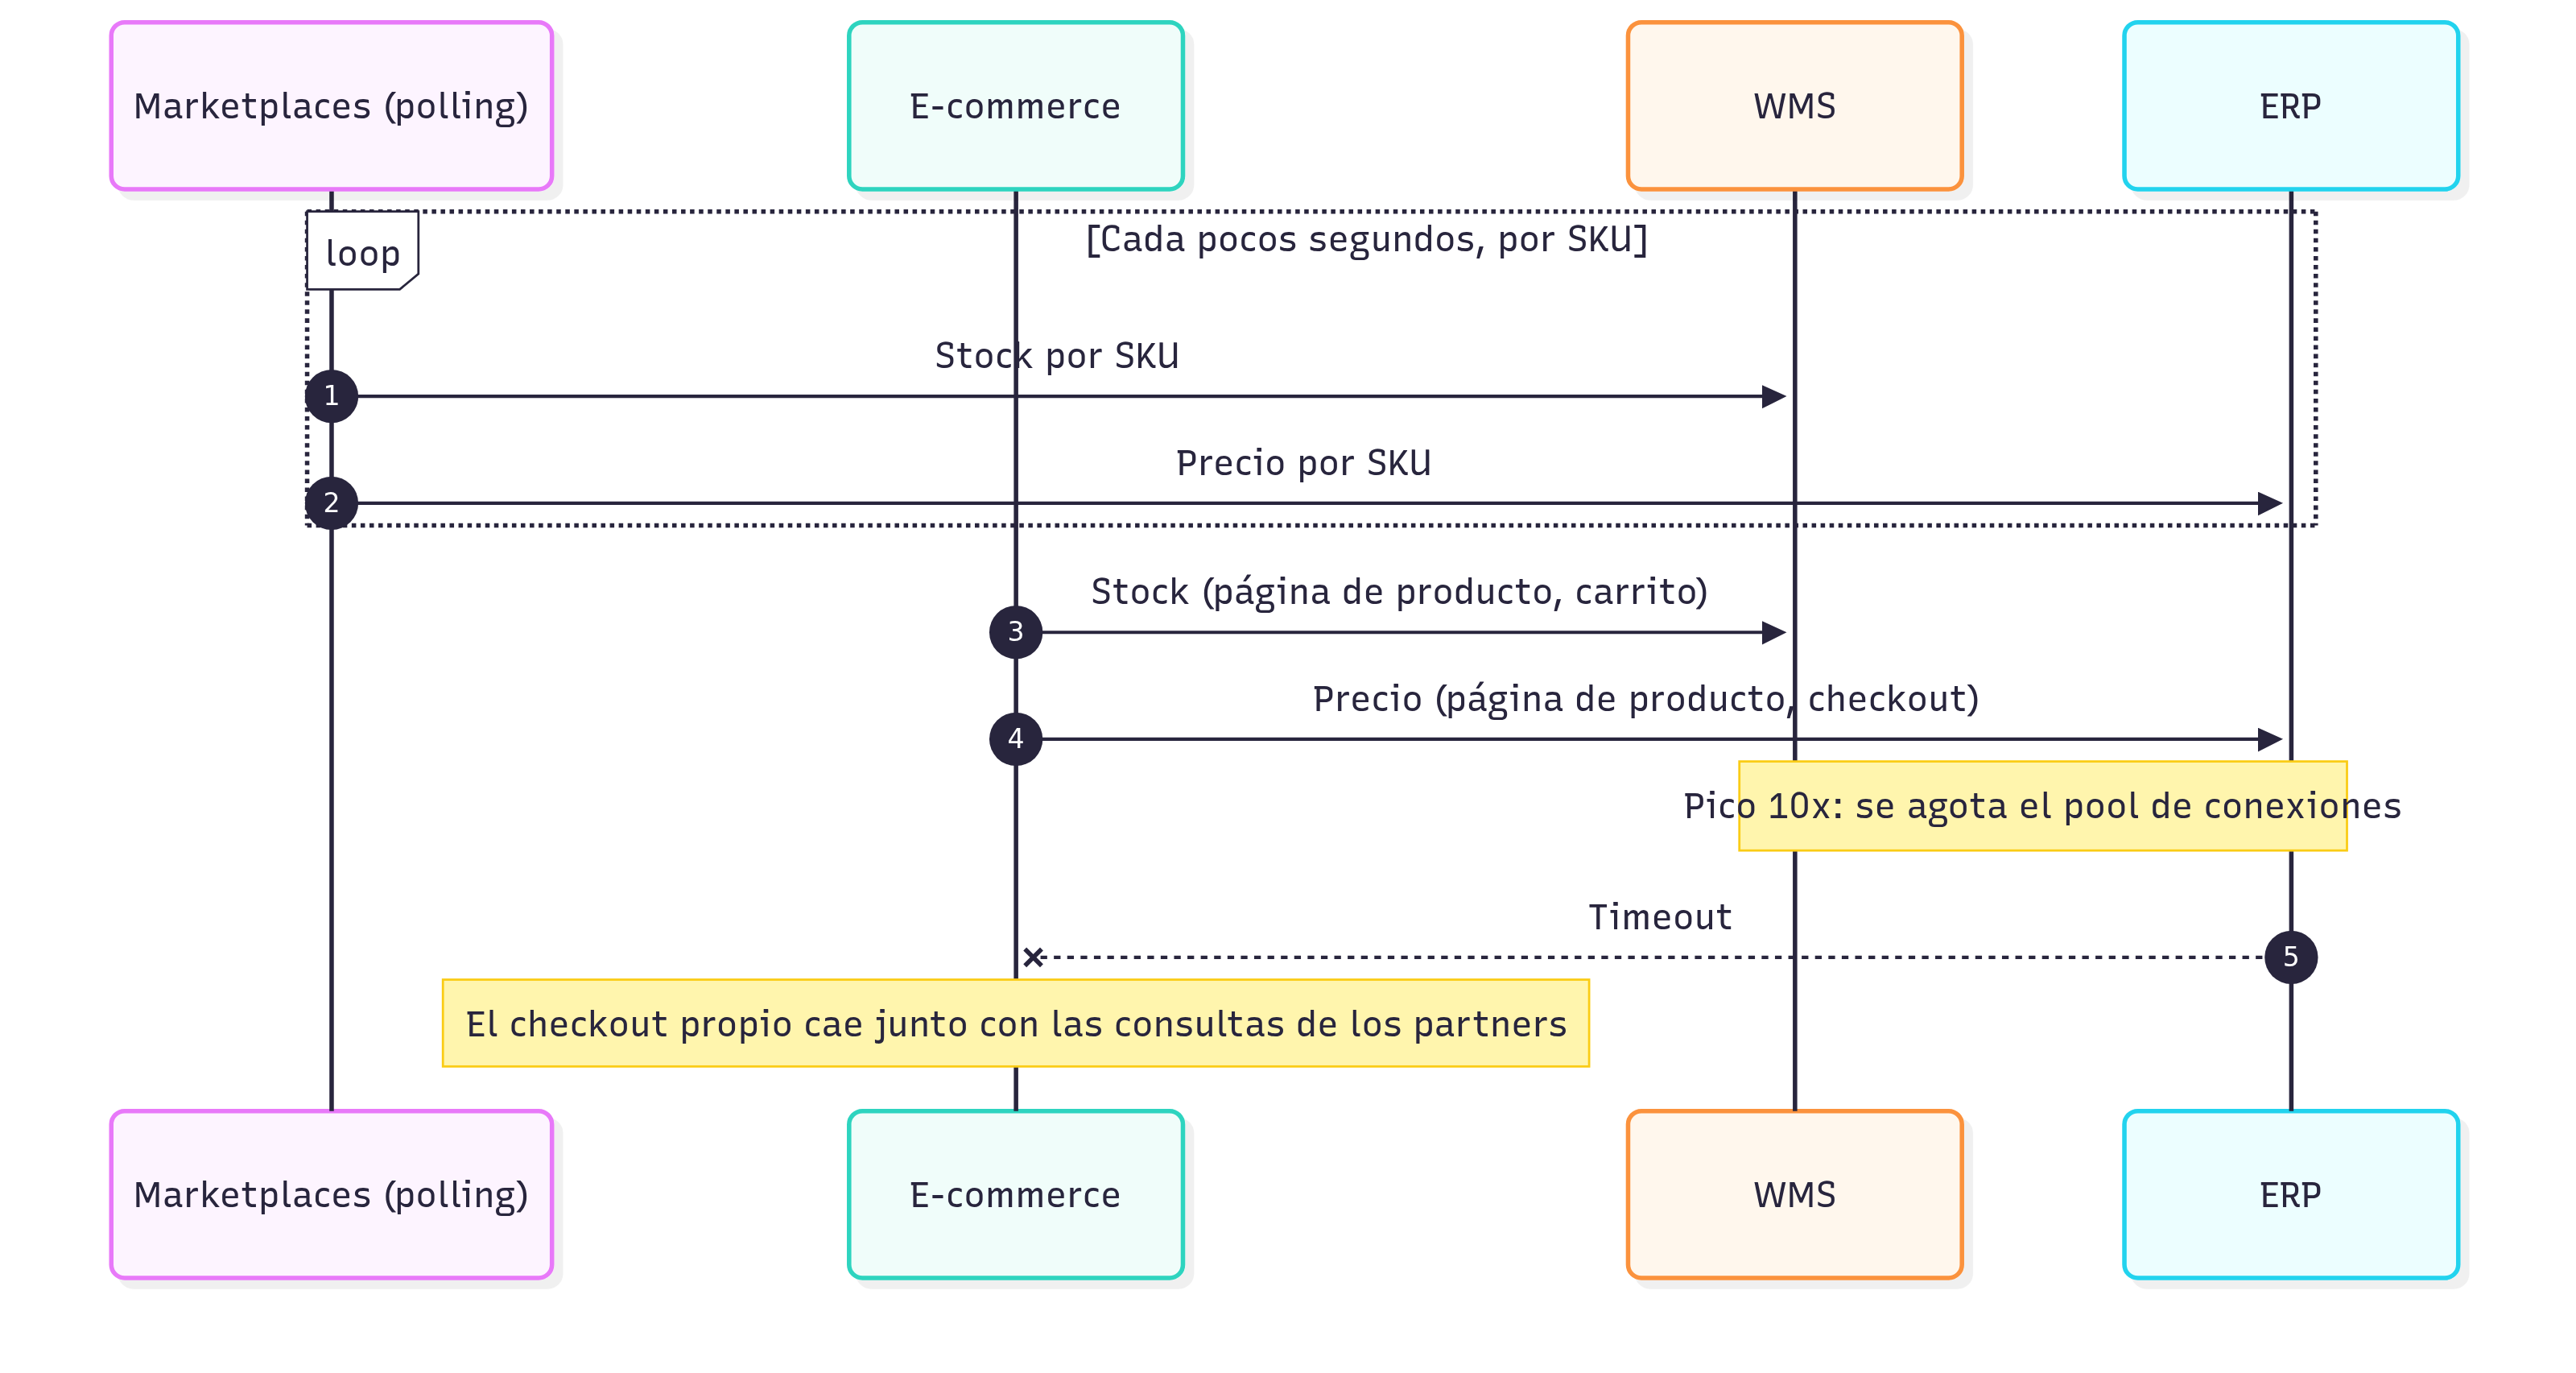
En el AS-IS cada consulta de un canal termina en una consulta en línea al WMS o al ERP. Una promo que multiplica por 10 las consultas multiplica por 10 la carga de sistemas que no escalan, y el checkout propio cae junto con las consultas de los partners.
En el TO-BE hay dos rutas con ritmos distintos: la de escritura va al ritmo de los cambios del legado y la de lectura al ritmo de los canales.
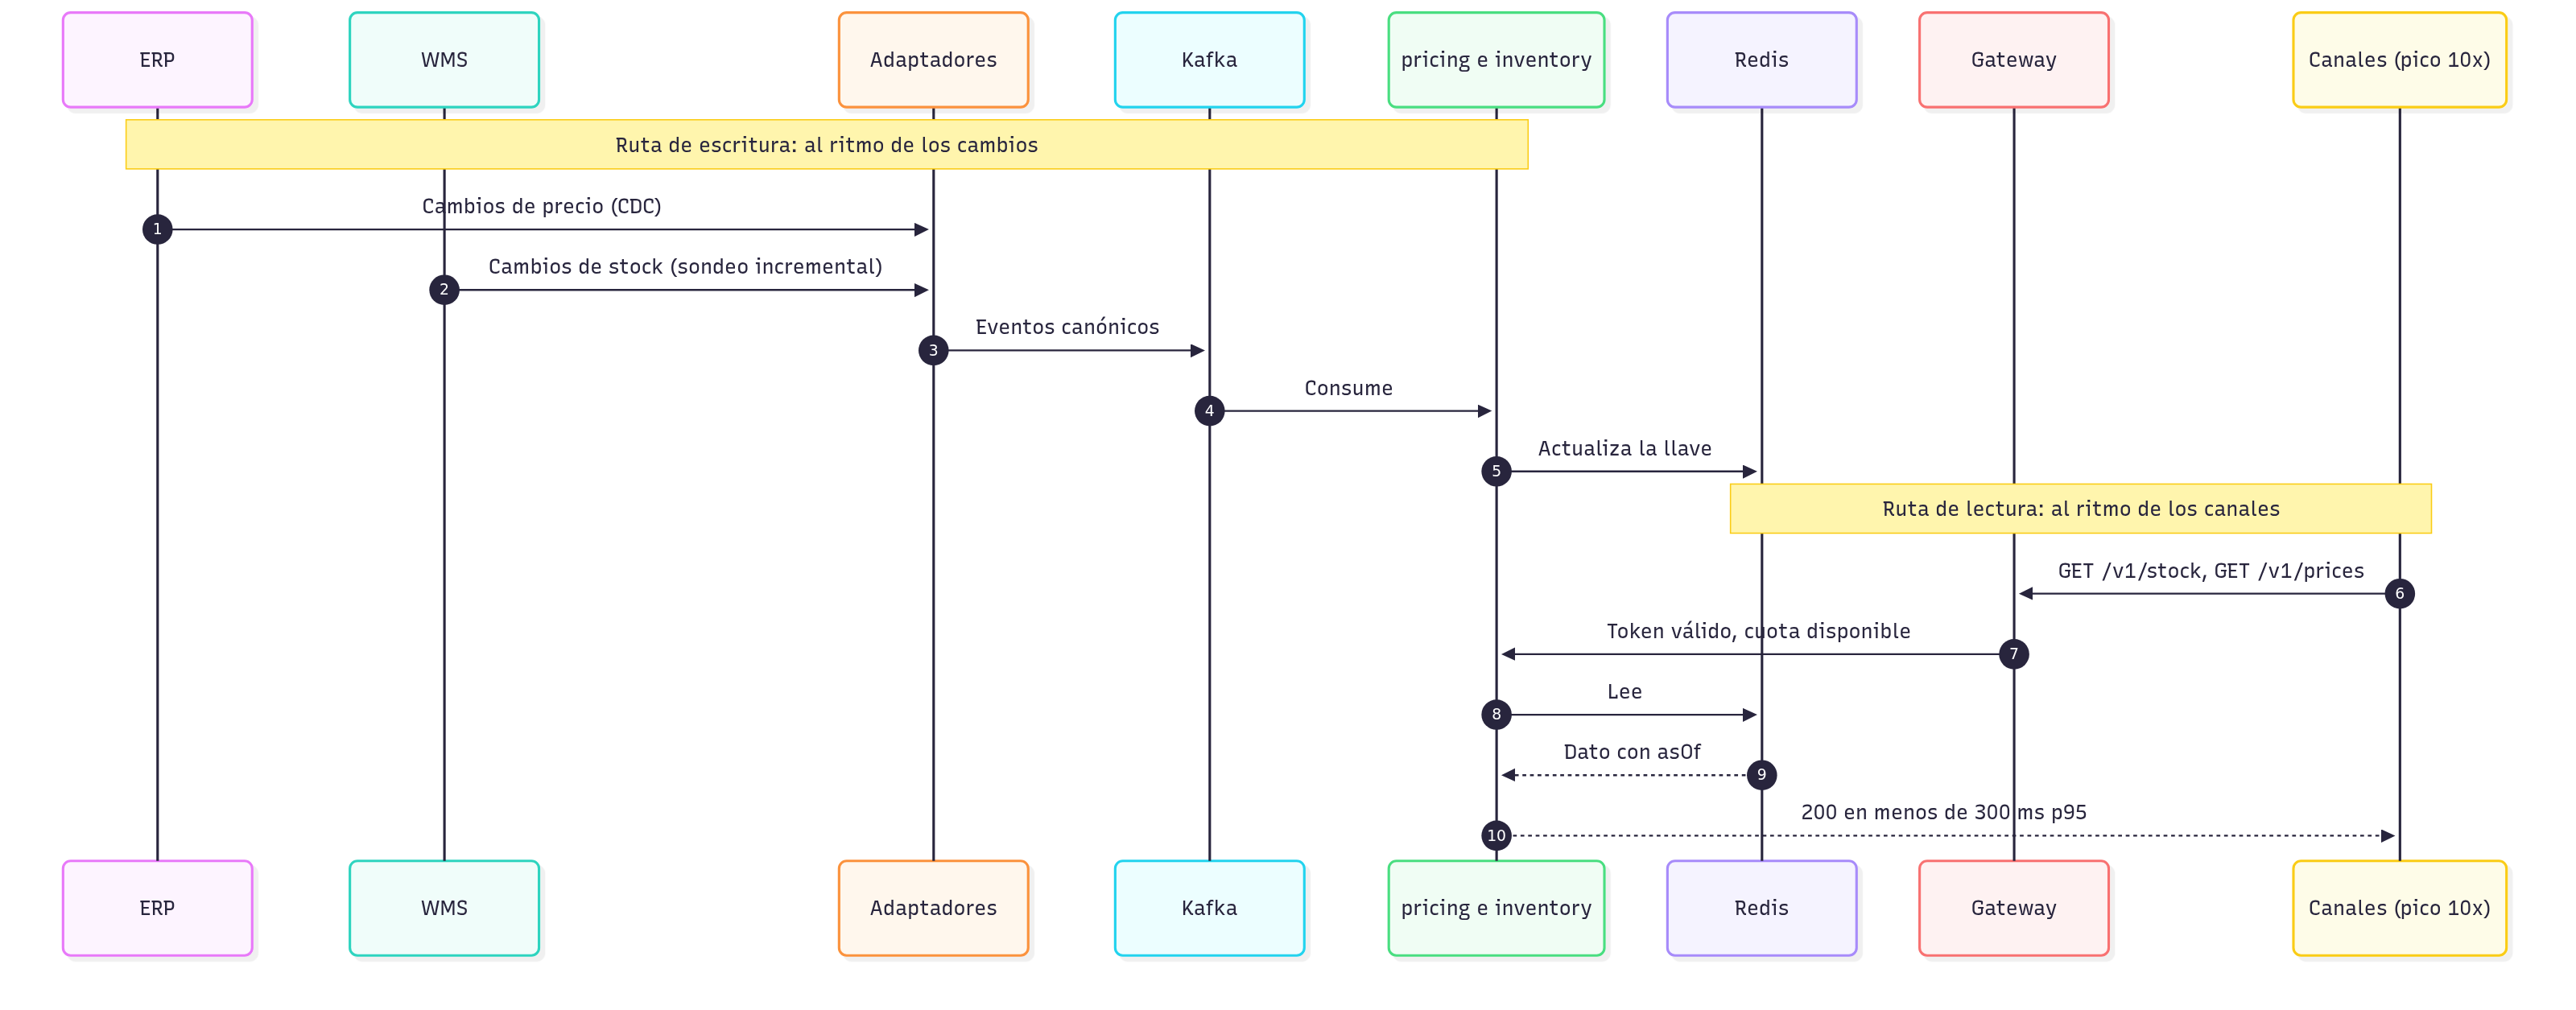
Presupuesto de latencia p95, como objetivo de diseño: borde (Cloudflare y balanceador) 20 ms, gateway 10 ms, malla con dos sidecars 5 ms, servicio 15 ms, Redis 5 ms. Total interno: 55 ms, con margen amplio frente a los 300 ms. Capacidad: con el supuesto S4 de 2.000 consultas por segundo y lotes promedio de 10 SKU, son 20.000 lecturas de llave por segundo, holgado para un Redis con una réplica por zona.
| Falla | Comportamiento |
|---|---|
| Llave ausente en Redis | Se lee de la base del servicio y se repone la llave |
| Redis caído | Lectura desde la base con concurrencia limitada; si se satura, 503 con Retry-After |
| Kafka o adaptador detenido | Se sigue respondiendo con el último dato; al superar el umbral, stale: true y alerta |
| ERP, WMS o enlace on-prem caídos | Igual. El canal no percibe la caída del legado |
6.4 Protección de los legados (backpressure)
Backpressure es el mecanismo por el que un sistema lento frena a quien le envía trabajo en lugar de ahogarse.
- Por diseño: los canales no llegan al legado. Solo los adaptadores lo hacen.
- Bulkhead por sistema (límite de concurrencia por dependencia): máximo inicial de 10 llamadas simultáneas al ERP, 10 al WMS y 20 al OMS, más un límite de llamadas por segundo.
- Kafka como amortiguador: los comandos hacia el OMS se consumen al ritmo que el OMS aguanta. Un pico de órdenes alarga la cola, no la carga del OMS.
- Circuit breaker por sistema (corte automático de llamadas a una dependencia que falla): abre con 50% de fallos en una ventana de 20 llamadas y prueba de nuevo a los 30 segundos. Abierto, el adaptador pausa su consumo en vez de quemar reintentos.
- Timeouts de 2 segundos por llamada al legado. Nunca una espera sin límite.
- Sondeo adaptativo: si el WMS responde lento, el adaptador alarga su intervalo.
Trade-off: con el legado lento, el dato tarda más en llegar a la capa (crece la frescura) y las órdenes tardan más en registrarse en el OMS. Se prefiere eso a que el legado caiga.
6.5 Reintentos y DLQ
Una DLQ (dead letter queue) es la cola donde quedan los mensajes que fallaron tras agotar los reintentos, para revisarlos o reprocesarlos sin bloquear el flujo.
| Caso | Política |
|---|---|
| gRPC de reserva | 2 reintentos con espera exponencial y jitter (variación aleatoria de la espera), solo ante errores transitorios; presupuesto total de 300 ms |
| Llamadas de adaptadores al legado | 3 intentos (200 ms, 1 s, 5 s) con jitter, solo en operaciones idempotentes |
| Consumo de eventos | Reintento inmediato hasta 3 veces; luego al tópico de reintento con esperas de 1 minuto, 10 minutos y 1 hora; luego DLQ |
| Registro en OMS | Igual, pero no va a DLQ antes de 24 horas: es un paso que debe lograrse |
| Webhooks a partners | 8 intentos en 24 horas (10 s, 1 min, 5 min, 30 min, 1 h, 3 h, 6 h, 12 h); luego DLQ por partner |
- Errores no transitorios (esquema inválido, regla de negocio) van directo a DLQ, sin reintentos.
- Los reintentos nunca bloquean la partición: el mensaje fallido sale a su tópico de reintento y el consumidor sigue. En oms-adapter, un mensaje con espera larga no frena a los demás del tópico de reintento (corregido el 15/11/2026). El
POSTque registra la orden en el OMS no se repite tras un timeout, porque podría duplicar la orden; se reintenta por el tópico de reintento. - El mensaje de reintento y el de DLQ son el original, salvo los datos sensibles: al pasar a la DLQ se reemplazan por
--data_redacted--y la cabeceraandes_payload_redactedlista qué campos se enmascararon (ADR-029). El tópico de reintento conserva el original, porque el reintento lo necesita; el token de pago nunca aparece en logs. - Cada DLQ tiene alerta y un procedimiento de reproceso con rol
ops-admin. - Tras varios fallos seguidos de un partner, su suscripción se pausa y se le notifica; los eventos quedan guardados para reenvío.
Trade-off: Kafka no trae reintentos ni DLQ nativos (con SNS y SQS, las colas y notificaciones de AWS, sí vienen), así que se construyen con tópicos. Se eligió Kafka porque permite releer el pasado para reconstruir el modelo de lectura y garantiza orden por llave.
6.6 Plan para promos
Antes:
- Prueba de carga a 10x del tráfico esperado, en un entorno igual al productivo, dos semanas antes.
- Subir el mínimo de réplicas de inventory-service, pricing-service y gateway por escalado programado. No depender del autoescalado reactivo en el primer minuto.
- Precalentar el modelo de lectura y verificar la frescura.
- Revisar cuotas con cada partner; subir de nivel a quien lo necesite.
- Congelar despliegues desde 24 horas antes.
Durante:
- Activar el modo promo: microcache de 2 segundos en el gateway.
- Subir la frecuencia de sondeo del WMS solo para los SKU en promoción.
- Tablero de promo a la vista: p95, frescura, cuotas agotadas, llamadas al legado, órdenes por estado.
- Degradaciones preparadas, de menor a mayor: servir dato con
stale: true, bajar el tope visible de stock, reducir cuotas de los niveles bajos.
Después: revisión con datos, ajuste de colchones de seguridad y de cuotas.
6.7 Escalabilidad
| Componente | Cómo escala |
|---|---|
| Gateway y servicios de lectura | Horizontal, por uso de procesador (CPU) y peticiones por segundo; sin estado |
| order-service y payment-service | Horizontal; el orden lo da la partición de Kafka |
| Adaptadores | No escalan con el tráfico: su límite es el legado |
| Redis | Réplicas de lectura por zona; partición por llave si el catálogo crece 10x |
| PostgreSQL | Una instancia por servicio; réplica de lectura para el respaldo de lecturas |
| Kafka | Más particiones y consumidores |
6.8 Evidencia
El mismo escenario de carga se corre contra los dos lados: el AS-IS (simuladores de ERP y WMS consultados directo, como hoy lo harían los canales) y el TO-BE (por la capa). La escala del demo es 20 consultas por segundo en base y 200 en pico: lo que importa es la proporción 10x. Las cifras son de un solo equipo de desarrollo con Docker Desktop, no de producción: sin red entre zonas, sin cifrado en tránsito, sin Cloudflare ni malla. Lo que se compara es el comportamiento a la misma escala y en el mismo equipo; la latencia de producción tiene su presupuesto en la sección 6.3. El umbral de stale del precio se bajó a 45 s para la prueba de caída (en el diseño es 30 minutos). Archivos crudos en tests/load/results/.
| Medida | AS-IS | TO-BE |
|---|---|---|
| p95 de stock y precio en tráfico base | Stock 128 ms, precio 196 ms | 3 ms los dos |
| p95 de stock y precio en pico 10x | 5.001 ms los dos: el timeout del canal | 1,6 ms los dos |
| Tasa de error en pico 10x | 100% en stock y en precio | 0% en stock y en precio |
| Llamadas por segundo al ERP en pico 10x | 200 (20 en la base: crecen 10x con el tráfico); el ERP alcanza a atender 67 | 0,9, igual que en la base: es el sondeo del adaptador y no depende de las consultas. Igual en el WMS |
| ERP lento (3 s de latencia) | Precio con p95 de 5.001 ms (el timeout) y 99,6% de error | p95 de precio 1,9 ms y 0% de error; el circuit breaker del adaptador abre y las llamadas al ERP bajan de 0,9 a 0,1 por segundo |
| Con el ERP caído, ¿responde stock y precio? | Precio no (0,03% de respuestas correctas); stock sí, porque viene del WMS. Con el WMS caído, stock no | Sí, los dos: 100% de respuestas correctas durante 3 minutos de caída, y lo mismo con el WMS caído. El precio sale stale: true pasado el umbral y vuelve a stale: false 5 s después de que el ERP regresa |
| Frescura p95: del cambio en el legado a la respuesta de la API | No aplica: cada consulta lee el legado en línea | Precio 1,2 s (objetivo 60 s); stock 1,2 s (objetivo 10 s) |
| Orden creada dos veces por reintento | Sí: 20 de 20 órdenes reintentadas tras un timeout quedaron duplicadas | No: 20 primeros envíos vencidos por el timeout del canal y reintentados con la misma Idempotency-Key dieron 20 órdenes en la capa y 20 en el OMS, 0 de más |
Criterio de éxito en el TO-BE para el pico 10x: p95 menor a 300 ms, errores menores a 0,1% y llamadas al ERP y al WMS que no superan la base más 10%. Los seis escenarios de falla dirigida están en el anexo F.
La misma medición en la nube. El AS-IS se repitió en AWS el 14/11/2026 (17:30 a 17:48 UTC): simuladores del ERP, WMS y OMS en el clúster EKS (us-east-1, dos nodos m7i-flex.xlarge en dos zonas) y el generador de carga k6 dentro del mismo clúster, con los mismos scripts, la misma imagen y las mismas perillas que en el equipo de desarrollo. Sin internet, sin Cloudflare, sin gateway de entrada y sin malla: lo que cambia frente a la corrida local es la red entre nodos y el tope de procesador. Archivos crudos en tests/load/results/as-is-nube/.
| Medida | AS-IS en el equipo | AS-IS en la nube | TO-BE en la nube |
|---|---|---|---|
| p95 de stock y precio en tráfico base | Stock 128 ms, precio 196 ms | Stock 129 ms, precio 196 ms | Stock 10,7 ms, precio 8,6 ms |
| p95 de stock y precio en pico 10x | 5.001 ms los dos | 5.000 ms los dos: el timeout del canal | Stock 12,0 ms, precio 10,3 ms |
| Tasa de error en pico 10x | 100% en stock y en precio | 100% en stock y en precio | 0% (36.001 consultas) |
| Llamadas por segundo al ERP en pico 10x | 200; el ERP atiende 67 | 200 (20 en la base); el ERP atiende 66,6 | 0,9, igual que en la base |
| ERP lento (3 s de latencia) | Precio con p95 de 5.001 ms y 99,6% de error | Precio con p95 de 5.000 ms y 99,5% de error | Precio con p95 de 8,6 ms y 0% de error |
| Con el ERP o el WMS caído | Precio no (0,03%) con el ERP caído; stock no con el WMS caído | Igual: precio 0,03% con el ERP caído, stock 0,03% con el WMS caído | Stock y precio responden el 100% con el ERP caído y con el WMS caído |
| Orden creada dos veces por reintento | 20 de 20 | 20 de 20 (40 órdenes en el OMS para 20 órdenes lógicas) | 0 de más en 20 |
| Un partner excede su cuota (escenario 6) | No aplica | No aplica | Bronze a 5 veces su cuota: 20,2 aceptadas por segundo de 100 pedidas, 9.580 respuestas 429 (80%) con Retry-After; gold sin errores, p95 13,2 ms |
El AS-IS da en la nube lo mismo que en el equipo de desarrollo: su límite no es la máquina, es que cada consulta llega en línea al legado. El TO-BE se midió en la nube el 15/11/2026 (16:49 a 17:11 UTC, y el escenario 6 repetido a las 17:40 UTC), con los mismos scripts, la misma imagen de k6 y las mismas perillas, entrando por el gateway de entrada de Istio con HTTPS. Los seis escenarios cumplen. Sus p95 son mayores que en el equipo de desarrollo por el TLS del gateway, el mTLS de la malla y la red entre nodos. La primera corrida del escenario 6 incumplió: a bronze se le aceptaron las 100 lecturas por segundo, sin ningún 429, porque el servicio de cuotas no tenía usuario en Redis; se arregló y se repitió, y el detalle está en el README de la corrida. Archivos crudos en tests/load/results/to-be-nube/.
El flujo de órdenes (flujo A) se verificó de punta a punta el 11/11/2026, con todas las piezas reales detrás del borde y el token de cada partner (make f4-e2e). Son pruebas de comportamiento, que pasan o fallan, y no de carga; no tienen columna AS-IS porque el AS-IS no tiene saga ni compensación que probar (sección 4). Algunos tiempos de reintento se acortaron para que la prueba dure minutos (el reintento hacia el OMS, por ejemplo, de 1 minuto a 3 s); la saga, los vencimientos y la consulta a la pasarela usan los valores del diseño. Límite de la medición del OMS: el simulador no puede reproducir un OMS real y lento que confirme una orden después de que el adaptador ya la buscó. oms-adapter consulta si la orden existe antes de cada intento, pero no envía una llave de idempotencia al OMS; el "0 de más" vale para el simulador y queda por probar contra un OMS real.
| Prueba | Resultado en el TO-BE |
|---|---|
| Escenario 4: la pasarela rechaza el pago | Orden CANCELLED con PAYMENT_REJECTED, reserva RELEASED, el vendible baja con la reserva y vuelve a su valor; el partner recibe payment.rejected y order.cancelled firmados |
| Escenario 5: webhook de pago duplicado | Un solo evento registrado, un solo cambio de estado y un solo payment.approved al partner. Un webhook con firma inválida recibe 401 en el borde |
| Escenario 5: webhook de pago perdido | payment-service consulta a la pasarela y la orden se resuelve sola al minuto |
| OMS caído | La orden queda CONFIRMED con omsSync pendiente; cuando el OMS vuelve se registra una sola vez |
| F9: la misma orden 5 veces en paralelo | Una orden y una reserva: un 202 y cuatro 409 REQUEST_IN_PROGRESS; el sexto envío recibe la respuesta original |
| 100 pedidos simultáneos por la última unidad | Gana uno; los 99 restantes reciben INSUFFICIENT_STOCK; sin sobreventa |
| F7: un partner pide la orden de otro | 404 NOT_FOUND, igual que por una orden inexistente |
| F6 y F8: trazabilidad y datos personales | El correlationId de la orden aparece en los logs de los cinco componentes por los que pasa (order, inventory, payment, oms-adapter y webhook-service); ningún dato personal de la corrida aparece en los logs de los servicios ni del borde |
| Camino feliz | PENDING_PAYMENT, CONFIRMED, DISPATCHED, DELIVERED. El despacho y la entrega salen del WMS simulado por wms-adapter (DispatchStarted, DeliveryConfirmed), ya no se publican a mano, y la reserva pasa a CONSUMED; el receptor del partner verifica la firma de cada webhook y recibe los eventos de la orden en su secuencia. Un evento de pago viaja por otro tópico y puede cruzarse con uno de orden: el partner ordena por time |
La malla se probó en vivo el 14/11/2026 en un clúster local de Kubernetes (kind, Kubernetes in Docker: un clúster que corre en contenedores del equipo), con Istio y sus sidecars, el proveedor de identidad, el gateway y el gateway de entrada (make mesh-kind-test). El clúster se crea para la prueba y se borra al final.
| Prueba | Resultado en el TO-BE |
|---|---|
| Escenario 6: un partner excede su cuota | El partner bronze pide 100 lecturas por segundo, 5 veces su cuota: recibe 20,1 por segundo y el resto (79,9%) en 429 RATE_LIMITED con Retry-After. El partner gold, al mismo tiempo: 0 errores y p95 de 6,6 ms (8,2 ms sin el exceso del otro) |
| mTLS estricto | Una carga sin sidecar no logra conectarse a un servicio, ni con un token válido |
| Llamada directa a un servicio, sin pasar por el gateway | 403 dentro de la malla |
| Salida al legado | Solo el adaptador de cada sistema llega a él |
| Circuit breaker de la malla | Expulsa al ERP lento, responde 503 de inmediato y se recupera a los 30 s |
En el AS-IS el escenario 6 no aplica: no hay cuotas por partner y cada canal llega al legado sin límite propio. Archivo crudo: tests/load/results/to-be/escenario-6-cuota-20261114T202635Z.json.