3. Arquitectura de alto nivel
Conclusión. La capa se pone entre los canales y los sistemas existentes y cambia tres cosas. Uno: las lecturas de stock y precio salen de un modelo de lectura propio, así que la carga sobre ERP y WMS depende de cuánto cambian los datos y no de cuántos los consultan. Dos: crear orden es una sola saga explícita, con reserva de stock, idempotencia y compensaciones, en lugar de una cadena repetida en cada canal. Tres: cada sistema existente queda detrás de un adaptador; agregar o reemplazar un sistema es agregar o cambiar un adaptador. El precio es más piezas que operar y consistencia eventual declarada en las lecturas.
3.1 Antes y después
Los diagramas usan el modelo C4 (diagramas de arquitectura en cuatro niveles de zoom: contexto, contenedores, componentes y código). Aquí se muestran los tres primeros niveles, sin bajar a clases ni métodos: el contexto de los dos lados (nivel 1, con los sistemas en las mismas posiciones para que se comparen), los contenedores del AS-IS (esta sección) y del TO-BE (sección 3.2), y los componentes de dos piezas del TO-BE (sección 3.2). El AS-IS es una hipótesis de trabajo construida desde los cinco problemas del enunciado.
| AS-IS: integraciones punto a punto | TO-BE: capa de interoperabilidad |
|---|---|
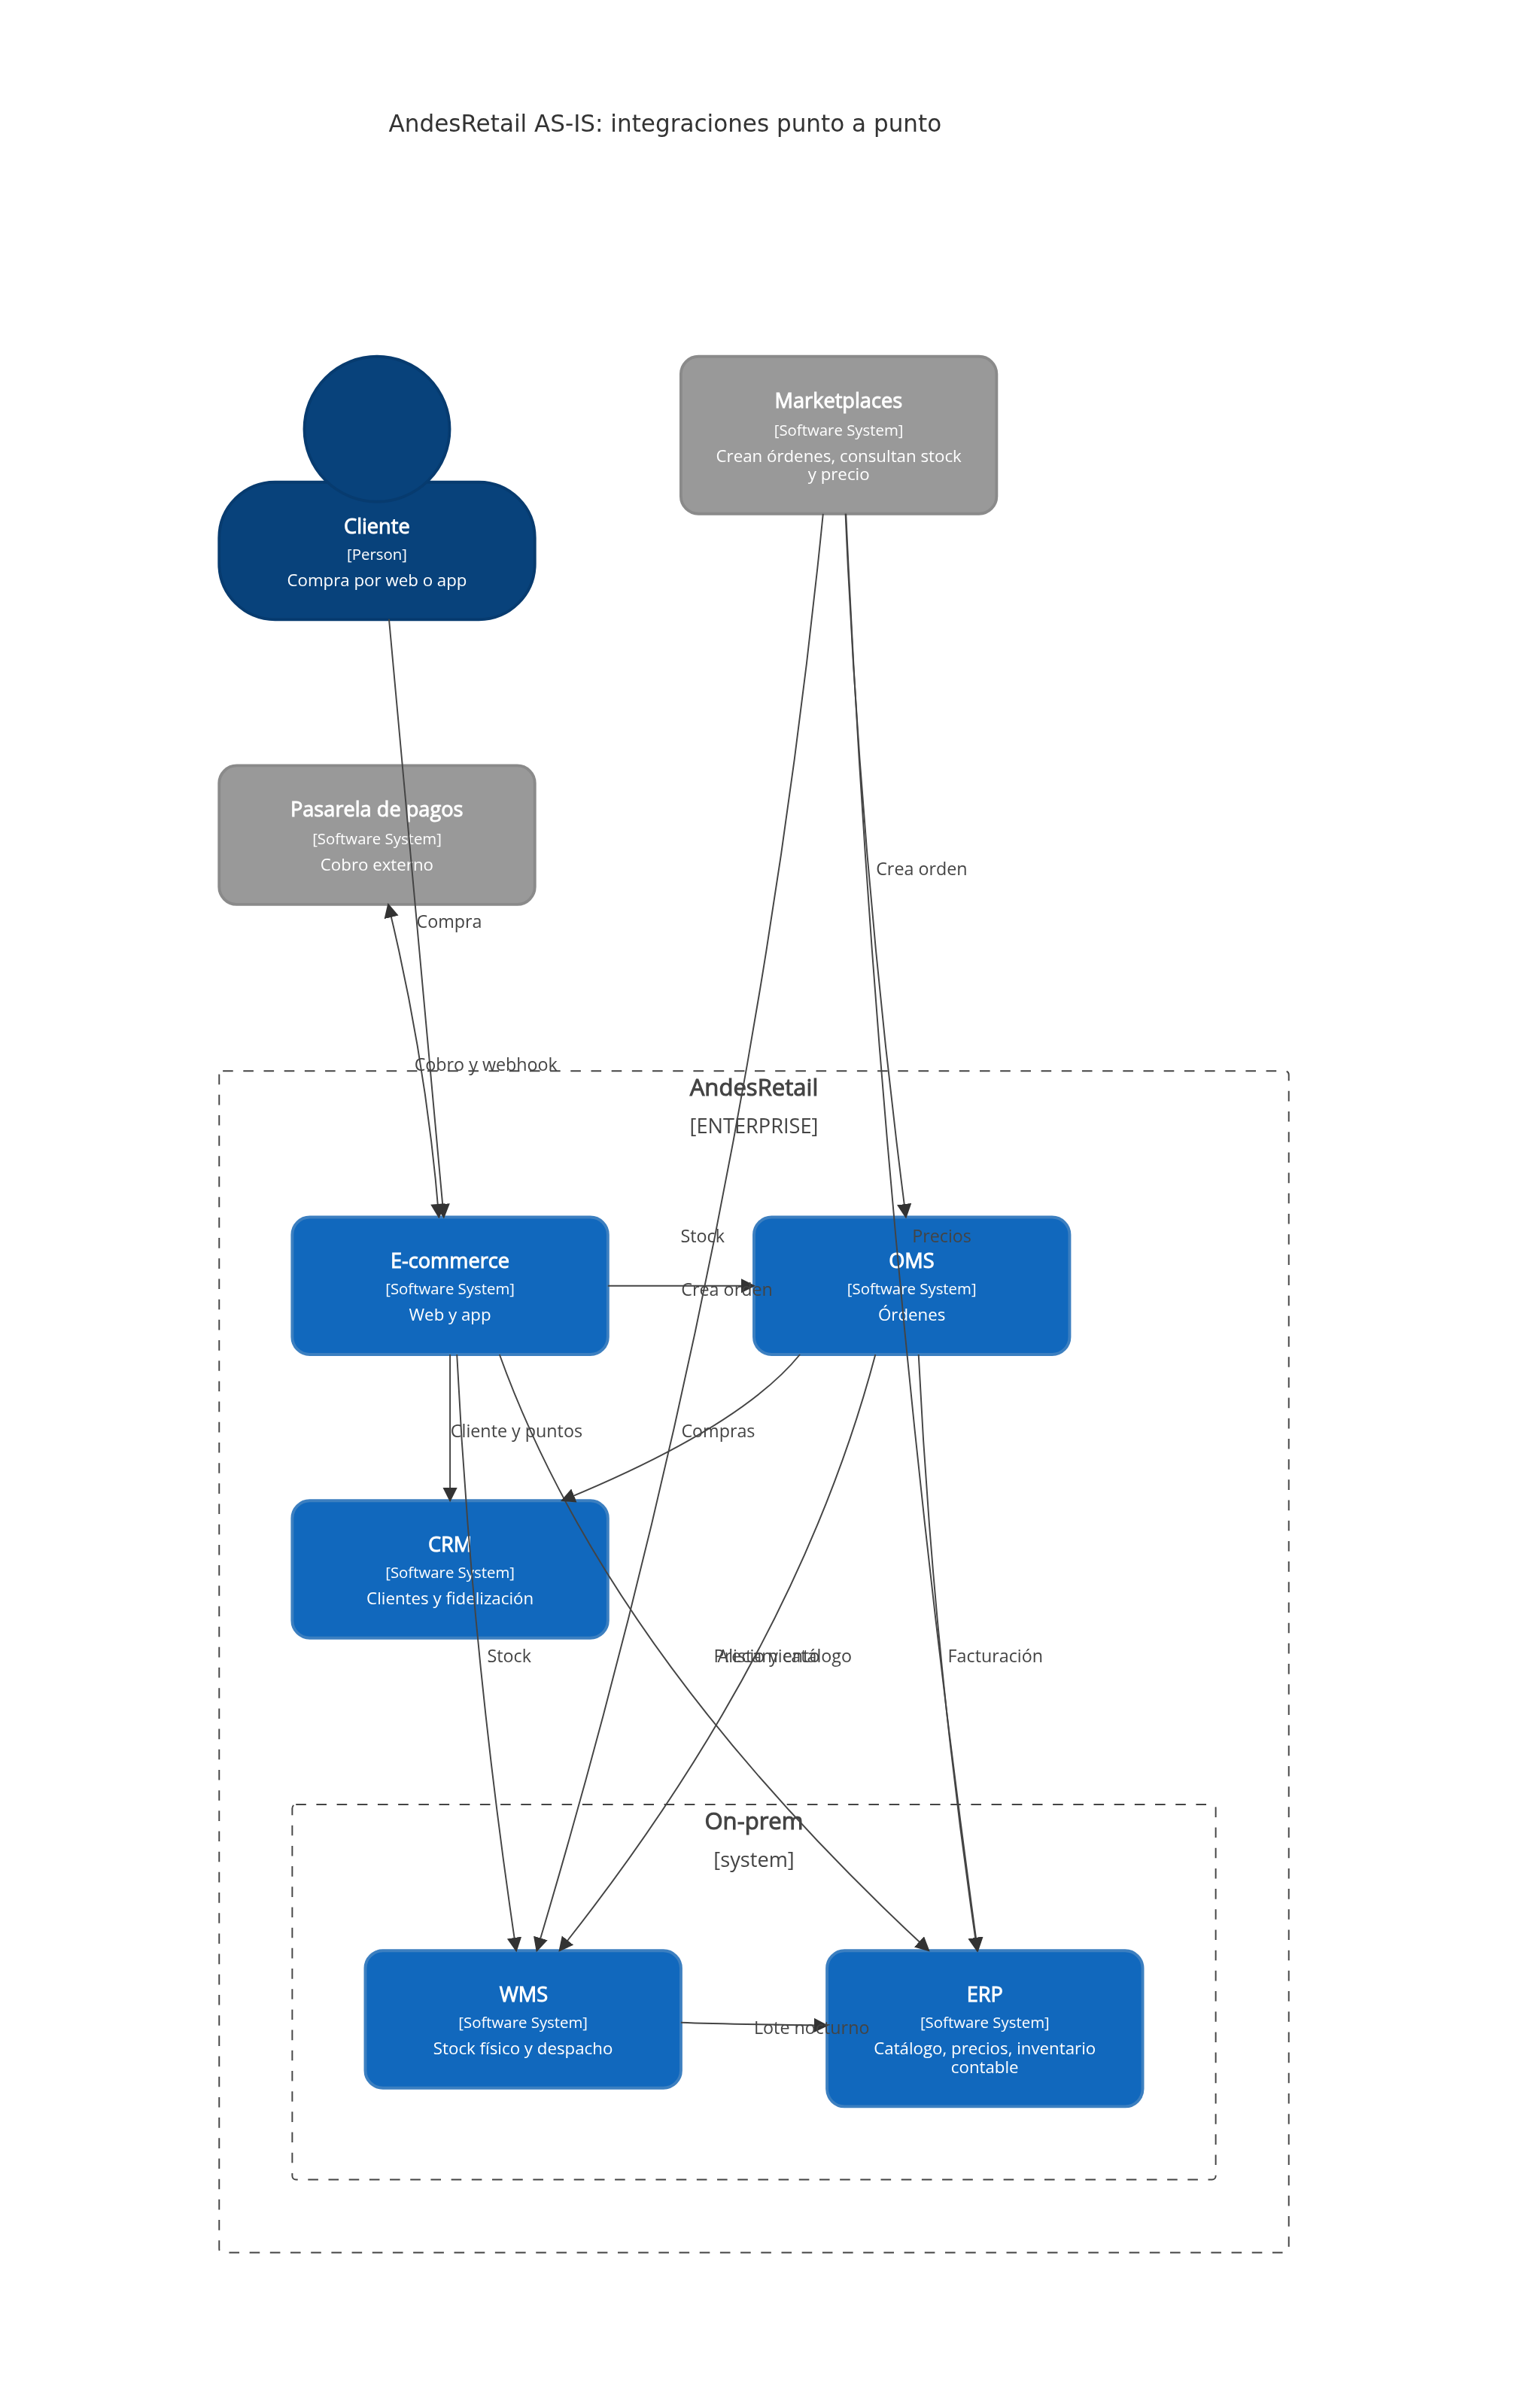 |
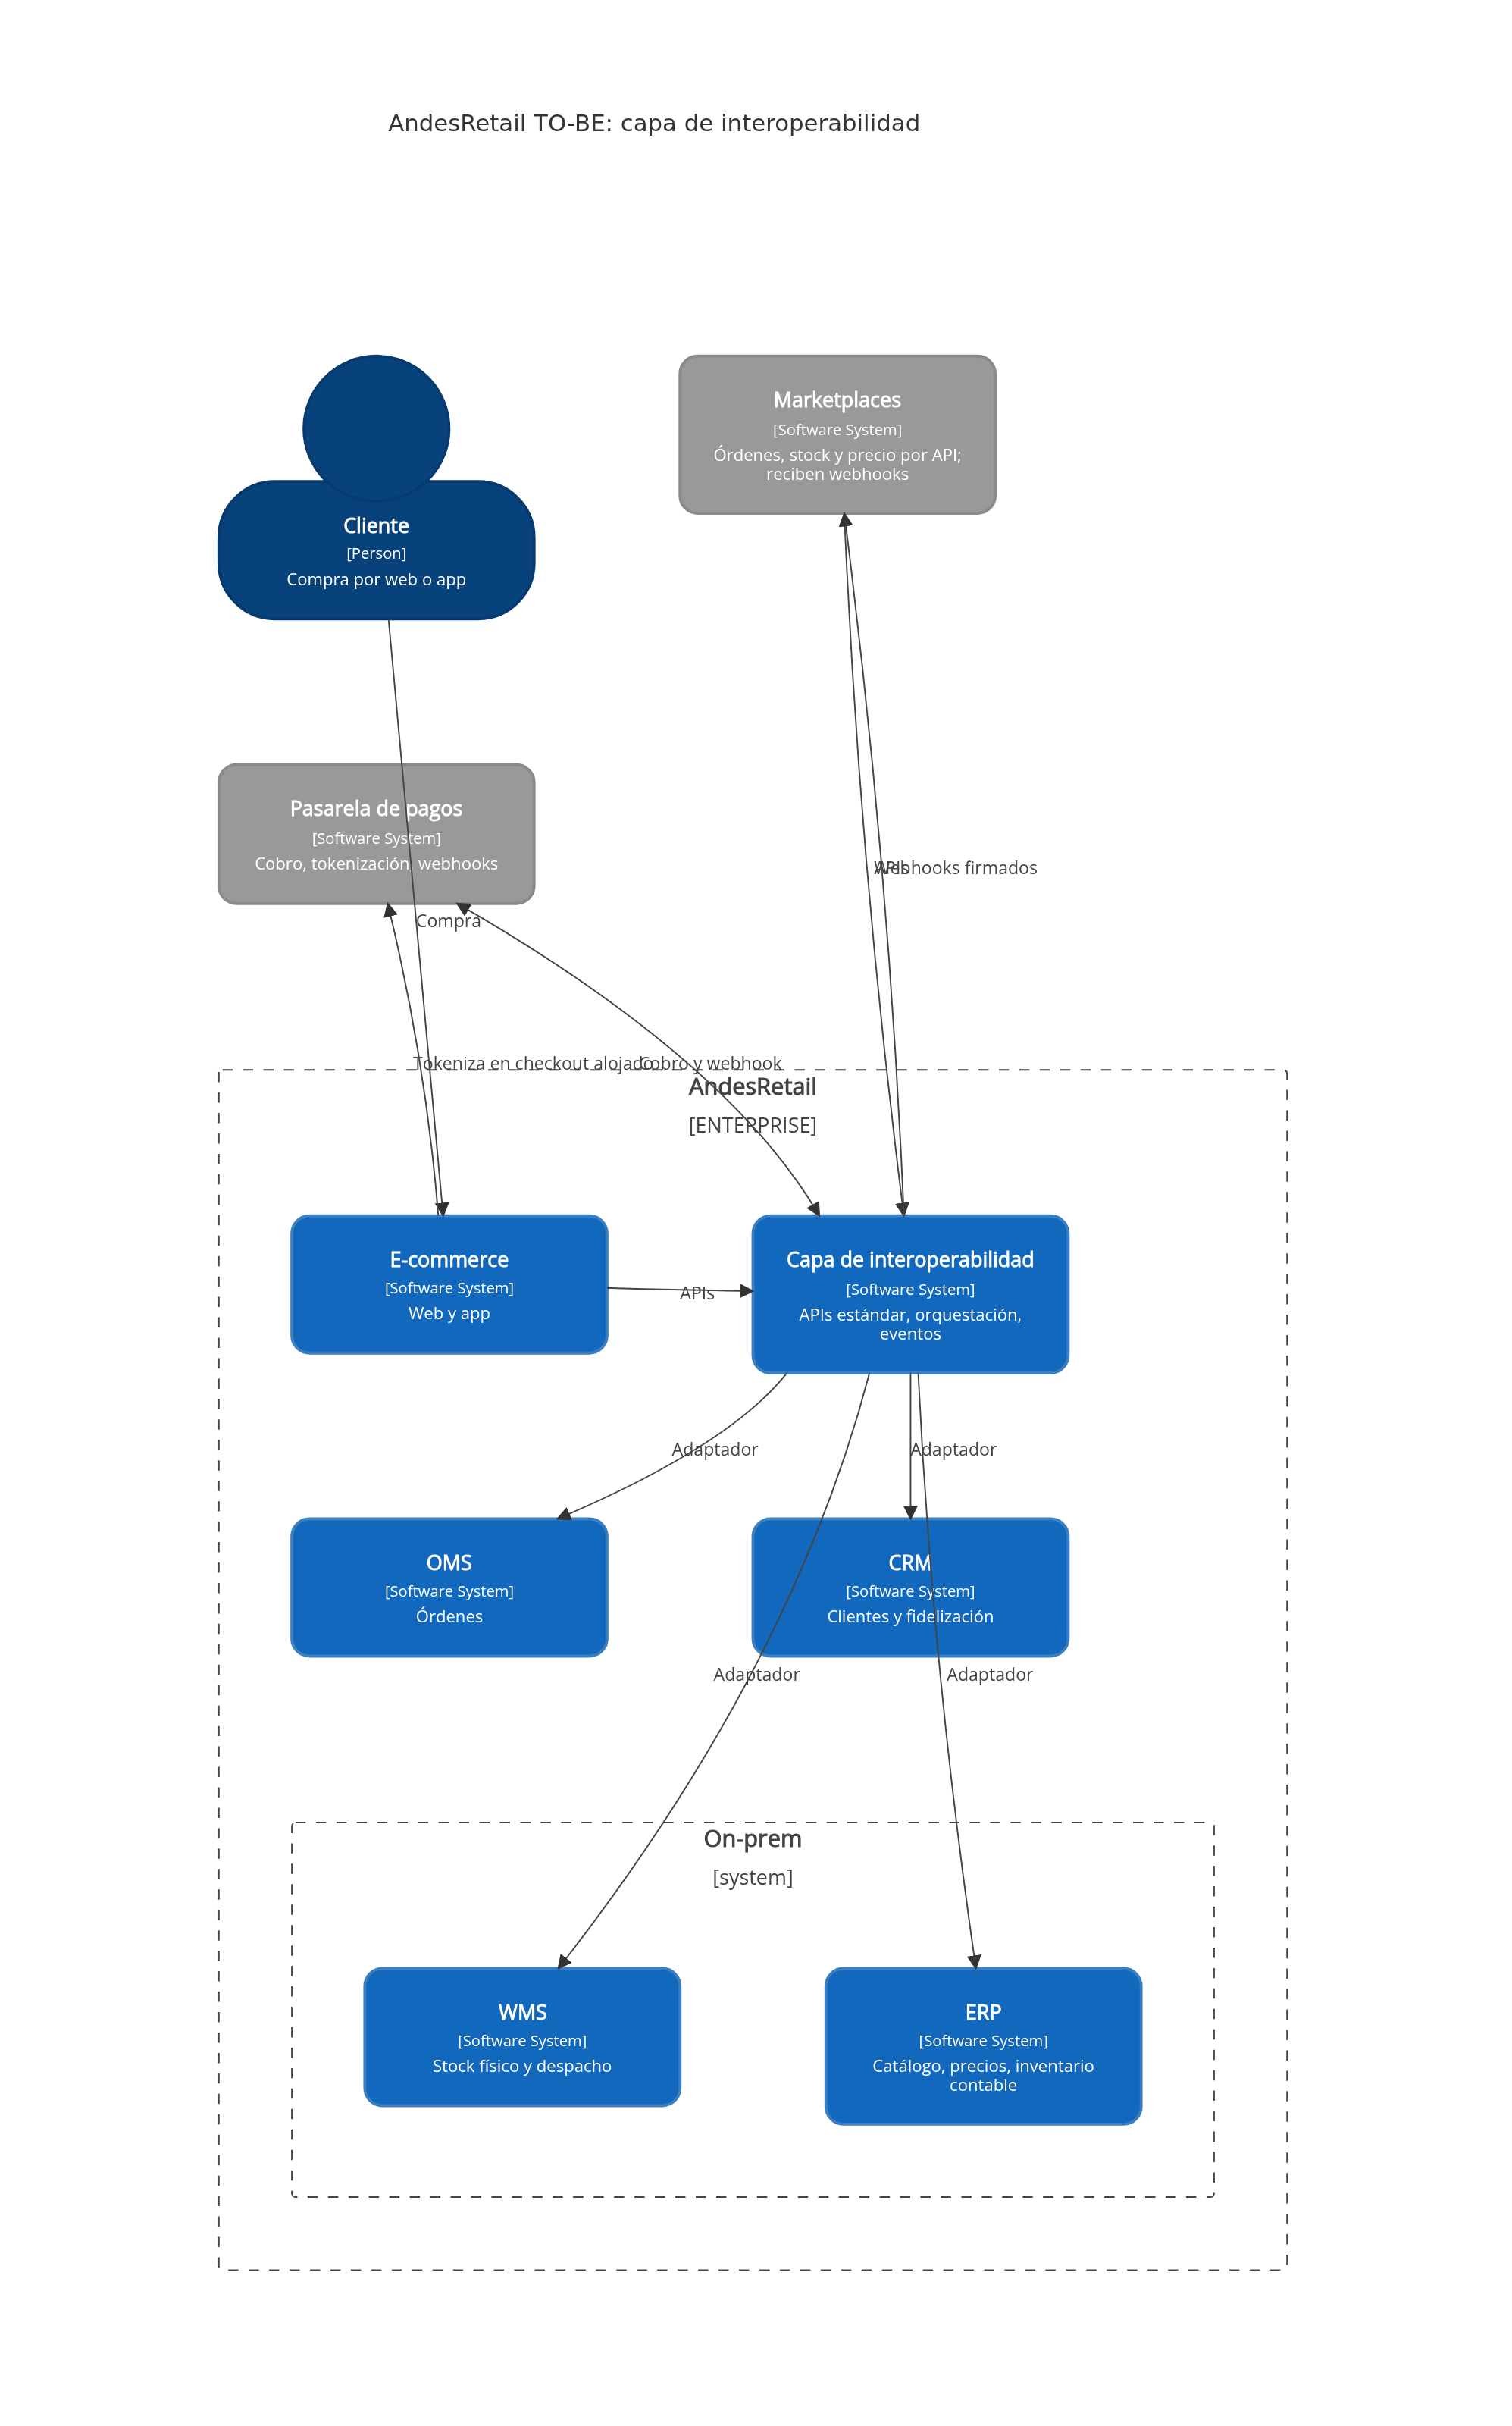 |
| AS-IS | TO-BE | |
|---|---|---|
| Conexiones de canales a sistemas | 8 directas, de 12 integraciones en total | 0: todo pasa por la capa |
| Quién conoce el formato de cada sistema | Todos sus consumidores | Solo su adaptador |
| Identidad | Una por integración | Un proveedor de identidad, un token, scopes |
| Dueño del stock vendible | Nadie | inventory-service |
| Dueño del flujo de crear orden | Cada canal | order-service |
Las integraciones internas entre sistemas (OMS con WMS, OMS con ERP, lote nocturno de WMS a ERP) no se tocan en el MVP; se evalúan en la hoja de ruta (sección 8).
Por dentro, el AS-IS en el nivel 2 del C4 (contenedores):
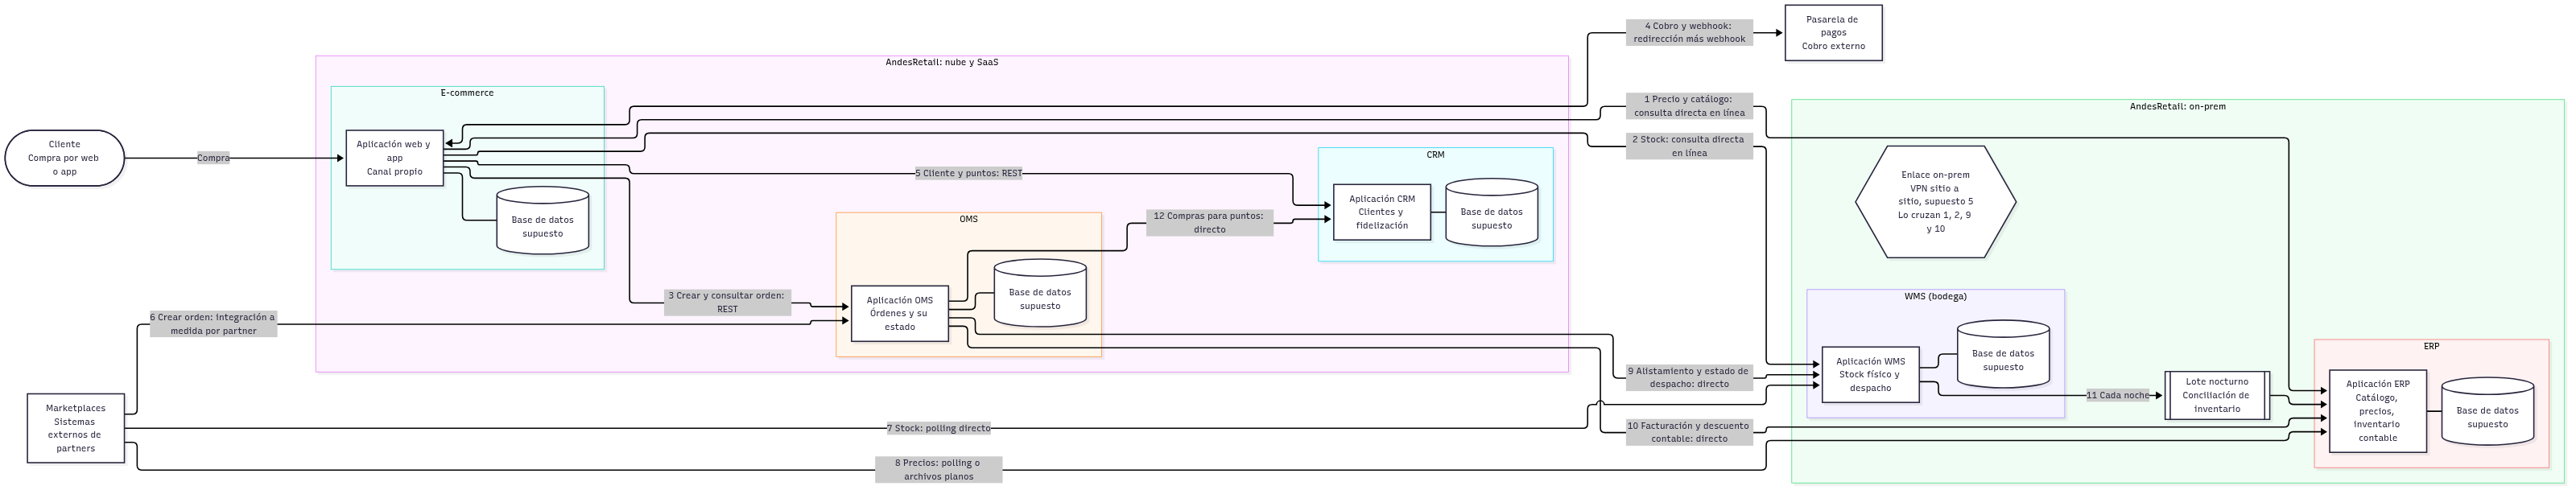
Muestra cada sistema como una aplicación con su base de datos, el lote nocturno que concilia WMS con ERP y el enlace VPN entre la nube y el on-prem, con las 12 integraciones numeradas como en la sección 8.1. Lo que se ve es el problema: seis de las doce integraciones (1, 2, 7, 8, 9 y 10) llegan a las aplicaciones de ERP y WMS, las dos que están on-prem, y cada una usa su propio formato y su propia autenticación. Lo asumido y no dicho por el enunciado, la base de datos de cada sistema y el enlace, está registrado como supuesto S26.
Cada problema del enunciado, su causa y el mecanismo que lo resuelve:
| Problema | Causa en el AS-IS | Mecanismo en el TO-BE | Cómo se mide |
|---|---|---|---|
| Integraciones punto a punto frágiles | 12 conexiones directas; la coordinación vive repetida en cada canal | Adaptador por sistema, modelo canónico, contratos versionados, saga única | Canales con acceso directo al legado: 0. Tiempo para sumar un sistema nuevo |
| Inconsistencias en stock, precios y estado | Sin dueño del stock vendible; lote nocturno; webhooks perdidos | Reserva atómica antes de aceptar; modelo de lectura por eventos con frescura medida; outbox y deduplicación | Órdenes rechazadas por sobreventa después de aceptadas: 0. Frescura p95. Órdenes atascadas |
| Incidentes en picos | Las lecturas de los canales llegan en línea al ERP y al WMS | Lecturas desde Redis; cuotas por partner; adaptadores con límite de concurrencia | p95 bajo 300 ms a 10x. Llamadas al legado planas durante el pico |
| Poca trazabilidad y auditoría | Ningún identificador cruza los sistemas | correlationId y traza distribuida en HTTP, gRPC (protocolo de llamadas remotas, sección 3.3) y eventos; registro de auditoría inmutable |
Porcentaje de órdenes con traza completa de punta a punta |
| Seguridad inconsistente | Una autenticación por integración; sin permisos por canal | OAuth2 y OIDC central, scopes, política por partner, cifrado mutuo interno, secretos gestionados | Rutas sin scope: 0. Credenciales directas al legado en manos de canales: 0 |
El p95 (percentil 95: el valor bajo el cual queda el 95% de las mediciones) es la forma en que el enunciado fija la latencia, y así se mide aquí.
3.2 Contenedores
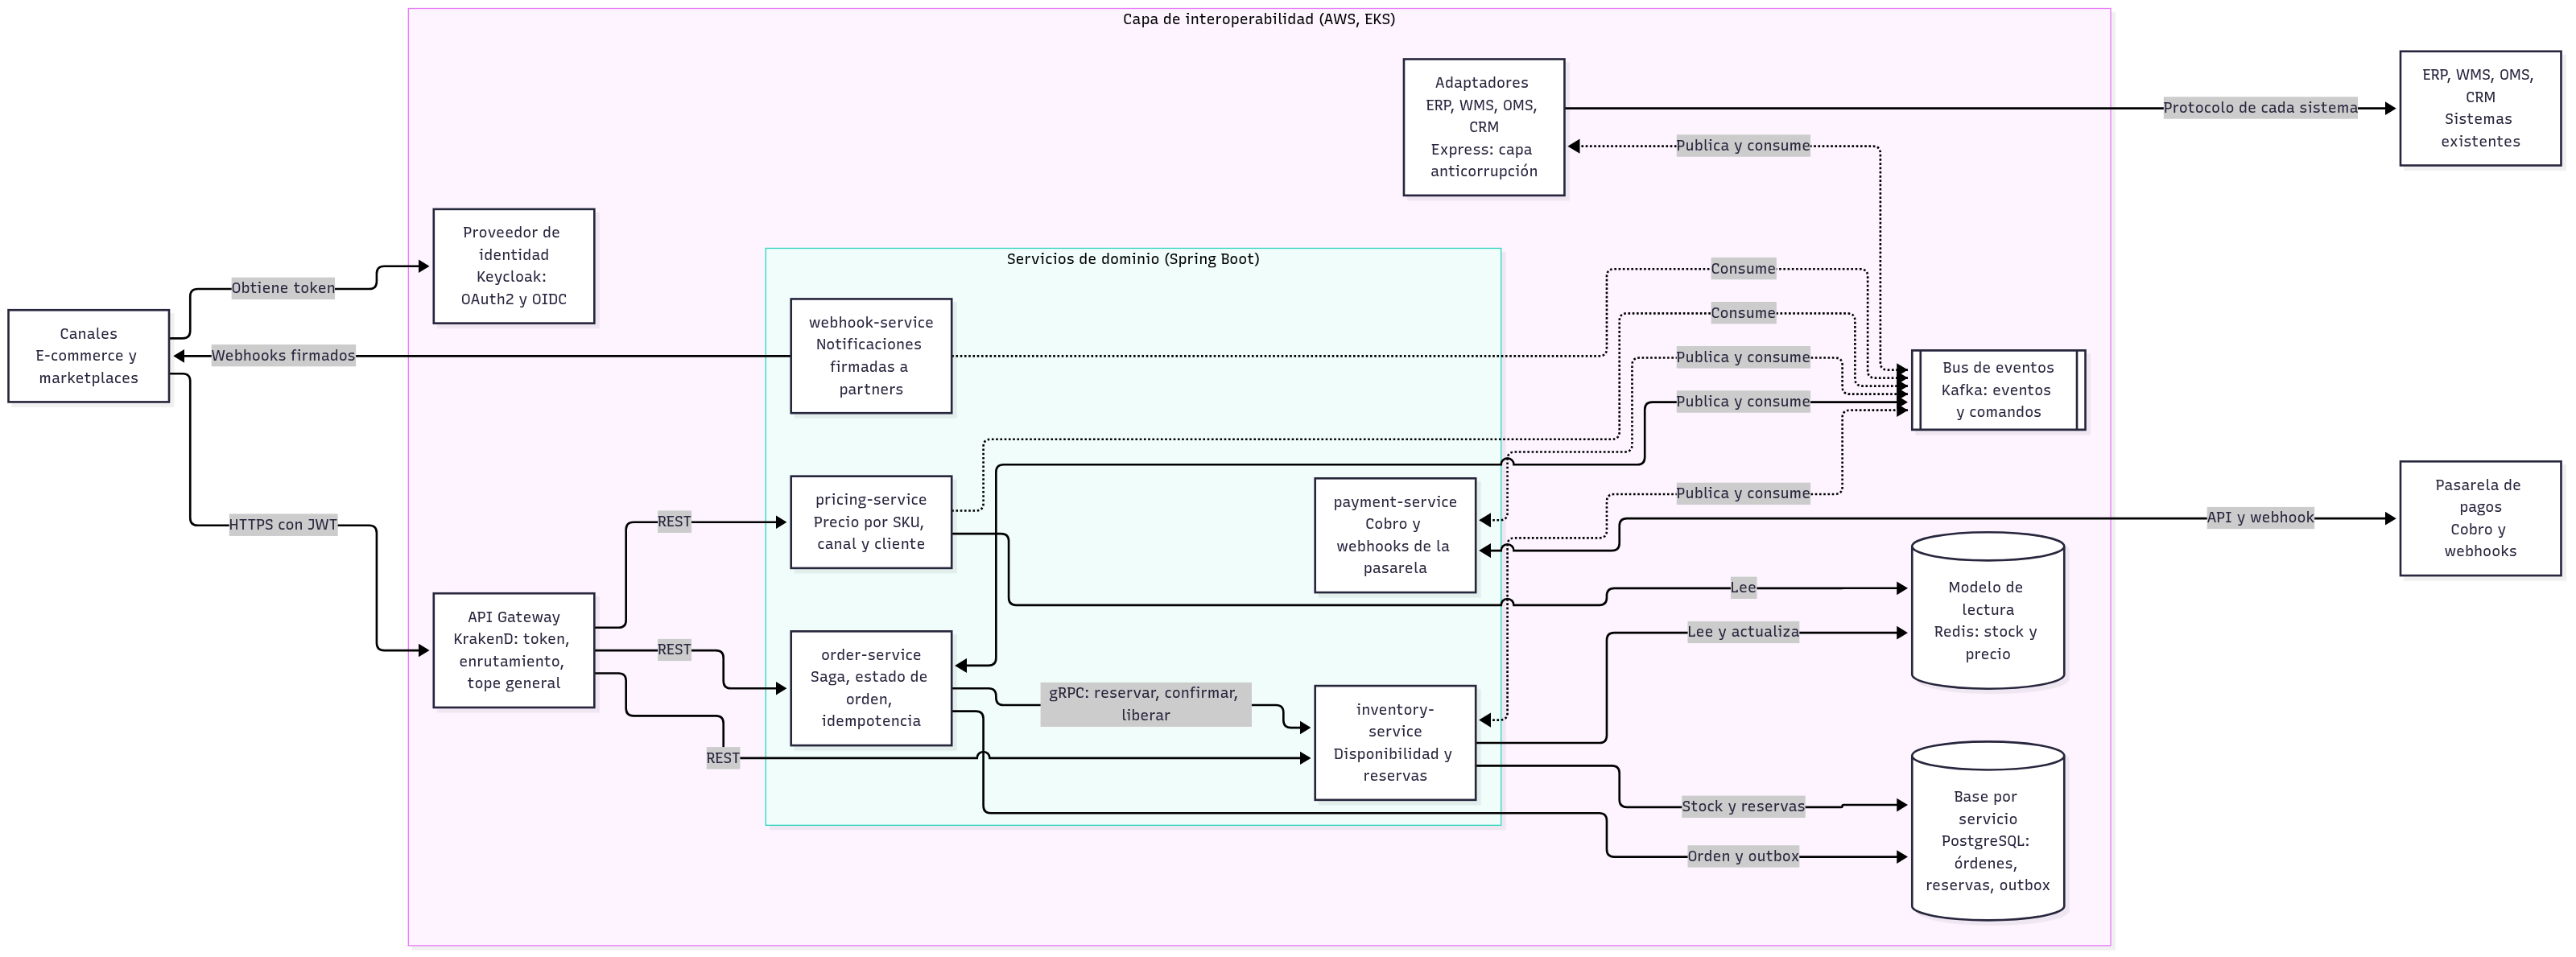
Es el nivel 2 del C4 (contenedores), con sus mismos elementos y relaciones, dibujado como diagrama de flujo para que las flechas se lean. Las líneas punteadas son eventos por Kafka. La capa corre en AWS sobre EKS (Elastic Kubernetes Service, el Kubernetes administrado de AWS), como sugiere el enunciado.
Un nivel más adentro, el nivel 3 del C4 (componentes) de dos de esos contenedores: order-service, el que orquesta la saga de crear orden, y erp-adapter, el adaptador del ERP. Cada caja es un paquete o un archivo del código; no se llega a clases ni métodos.
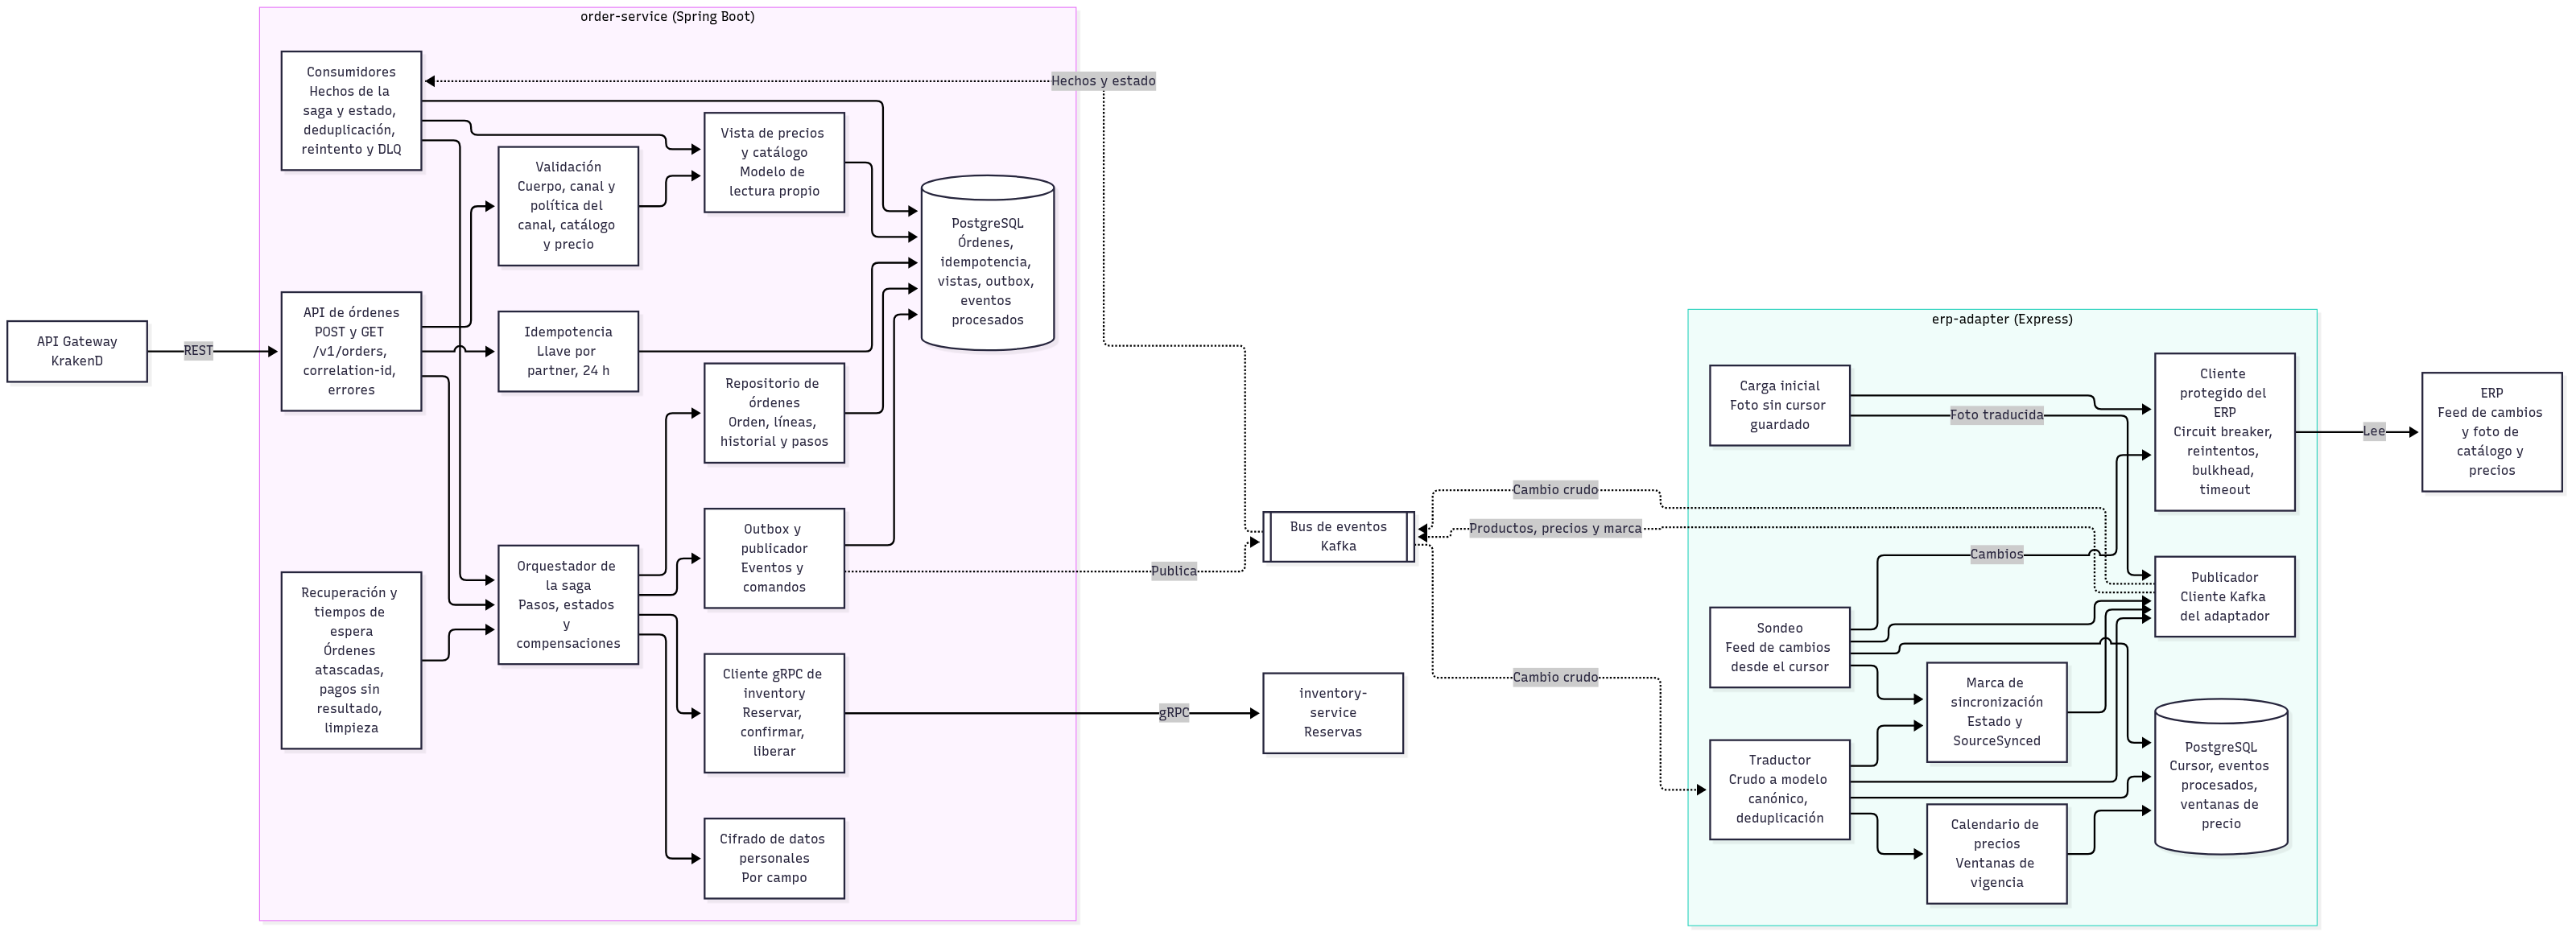
En order-service, la API valida idempotencia, cuerpo, canal, catálogo y precio contra su propia vista de precios (alimentada por eventos), reserva stock con una sola llamada gRPC a inventory-service y guarda la orden en su base; todo evento y comando sale por el outbox, y los consumidores continúan la saga con los hechos que llegan por Kafka, sin repetir efectos. En erp-adapter, el sondeo lee los cambios del ERP a través de un cliente con circuit breaker, los deja crudos en Kafka, y el traductor los pasa al modelo canónico; es el único componente con ruta de red al ERP. Este adaptador no usa outbox: confirma el crudo en Kafka antes de guardar su cursor y sus identificadores de evento son deterministas, así que repetir una lectura no duplica nada.
| Componente | Responsabilidad | Lo que no hace |
|---|---|---|
| API Gateway (KrakenD) | Valida el token, enruta, aplica tope general y por cliente, propaga el correlationId |
No transforma, no agrega respuestas, no decide negocio |
| Proveedor de identidad (Keycloak) | Emite tokens OAuth2 y OIDC; un cliente por partner con sus scopes, canal y nivel de cuota | No guarda datos de clientes finales en el MVP |
| pricing-service | Modelo de lectura de precios; resuelve lista de precios por canal y segmento de cliente | No calcula precios: los recibe del ERP |
| inventory-service | Stock vendible por SKU y ubicación; reservas con vencimiento | No reemplaza al WMS: el stock físico sigue siendo del WMS |
| order-service | Orquesta la saga, guarda el estado de la orden, garantiza idempotencia | No reemplaza al OMS: le entrega las órdenes confirmadas |
| payment-service | Inicia el cobro con el token de la pasarela, recibe y verifica sus webhooks | Nunca ve ni guarda datos de tarjeta |
| webhook-service | Entrega eventos a los partners con firma, reintentos y cola de fallidos | No decide qué pasó: solo notifica |
| Adaptadores ERP, WMS, OMS, CRM | Traducen entre el modelo canónico y cada sistema; protegen al legado con límites de concurrencia | No contienen reglas de negocio |
| Kafka | Transporte de eventos y comandos; estado reproducible del modelo de lectura | No es base de datos de consulta |
| Redis | Modelo de lectura de stock y precio para la ruta rápida | No es fuente de verdad de reservas |
| PostgreSQL | Una base por servicio: órdenes, reservas, outbox, idempotencia | Sin tablas compartidas entre servicios |
| Malla de servicios (Istio con Envoy) | Cifrado mutuo, reintentos, circuit breaker, cuota por partner, métricas de red | Sin lógica de dominio |
Principios que gobiernan todo lo demás:
- El dato tiene un solo dueño. La capa no reemplaza al ERP, al WMS, al OMS ni al CRM. Solo posee las reservas de stock, porque hoy nadie las tiene.
- La ruta síncrona de las APIs externas nunca llama a un sistema existente.
- Gateway delgado: identidad, enrutamiento y límites. Cero lógica de negocio.
- Modelo canónico adentro; el formato de cada legado solo existe en su adaptador.
- Todo evento se publica con outbox y se consume de forma idempotente.
- Las capacidades transversales (telemetría, cifrado entre servicios, reintentos, secretos) las pone la plataforma, no el código de dominio.
- Cada requisito no funcional tiene una función de aptitud definida, con su estado real: compuerta, prueba ejecutable o diseño (sección 3.8).
3.3 Decisión clave 1: qué es síncrono y qué es asíncrono
La regla: es síncrono lo que el canal necesita saber antes de seguir y que la capa puede responder con sus propios datos. Es asíncrono todo lo que depende de un sistema que la capa no controla.
| Tramo | Modo | Por qué |
|---|---|---|
| Consulta de stock y precio | Sync, contra el modelo de lectura | El canal necesita la respuesta ya; la capa la tiene en Redis sin tocar el legado |
| Alimentar el modelo de lectura desde ERP y WMS | Async (eventos) | Desacopla el ritmo de lectura del ritmo de cambio; absorbe caídas del enlace on-prem |
| Crear orden: validar token, catálogo y precio | Sync | Errores que el canal puede corregir de inmediato |
| Crear orden: reservar stock | Sync (gRPC interno) | Evitar sobreventa exige una respuesta atómica antes de aceptar la orden |
| Crear orden: cobro | Async | Depende de la pasarela, que es externa y responde por webhook |
| Crear orden: registrar en OMS | Async | El OMS no debe poder tumbar ni frenar la aceptación de órdenes |
| Consultar estado de orden | Sync, contra la base de order-service | Dato propio de la capa |
| Notificar a partners | Async (webhooks) | El partner puede estar caído; se reintenta sin bloquear nada |
| Eventos de despacho y entrega | Async | Nacen en el WMS a su ritmo |
gRPC es un protocolo de llamadas remotas con contrato binario estricto; se usa en un único punto interno, de order-service a inventory-service, donde importan la latencia y la exactitud del contrato. Fuera de ese punto, los servicios de dominio no se llaman entre sí: se comunican por eventos.
Dónde no se usa async, y por qué: la reserva podría hacerse por eventos, pero entonces la orden se aceptaría antes de saber si hay stock, que es exactamente la sobreventa del AS-IS. Dónde no se usa sync: el registro en el OMS podría ser una llamada directa, pero haría que una caída del OMS impida vender.
Trade-off: crear orden responde 202 (aceptada) y no el resultado final. El canal debe consultar el estado o recibir el webhook. Se acepta porque el cobro ya es asíncrono por naturaleza (supuesto S9). Consecuencia verificable: con los sistemas existentes apagados, las lecturas siguen respondiendo y las órdenes se siguen aceptando.
3.4 Decisión clave 2: rol del API Gateway
Gateway delgado. Hace: terminar TLS (Transport Layer Security, el cifrado de HTTPS), validar firma y vigencia del token, exigir el scope de la ruta, tope general por endpoint y por cliente, tamaño máximo de petición, generar o propagar X-Correlation-Id. No hace: transformar cuerpos, componer respuestas, guardar estado ni aplicar reglas por partner más allá del scope.
Se eligió KrakenD (edición comunitaria) frente a Kong, que el enunciado sugiere como ejemplo:
| Capacidad | KrakenD comunitario | Kong código abierto |
|---|---|---|
| Validar tokens de Keycloak | Sí, con rotación automática de llaves | Sí, con el plugin JWT (JSON Web Token, sección 5.1); el plugin OIDC completo es de pago |
| Límites distintos por partner | No: misma tasa para todos los clientes de un endpoint | Sí: el plugin se configura por consumidor |
| Contadores compartidos entre instancias | No: memoria por instancia | Sí |
| Operación | Sin estado, configuración declarativa | Requiere base de datos o modo declarativo |
Trade-off: las cuotas diferenciadas por partner viven un salto más adentro, en la malla (sección 6.1), y hay dos lugares donde mirar límites. A cambio el gateway es sin estado, se despliega como configuración y no puede convertirse en un ESB. Se revisaría si AndesRetail necesitara portal de desarrolladores, planes de consumo o monetización de APIs.
La configuración del gateway no es un solo archivo que todos tocan. Cada equipo declara sus rutas junto a su servicio en un formato corto (routes.json: método, ruta, scope, timeout y grupo de cuota) y el pipeline las ensambla, valida y empaqueta:

El formato corto ni siquiera permite expresar una transformación: la regla "el gateway no tiene lógica" la impone la herramienta, no la buena voluntad. Lo que se sacrifica: los equipos no usan funciones avanzadas del gateway, y hay un ensamblador propio que mantener (la edición comunitaria no admite directorios anidados).
3.5 Decisión clave 3: dónde se transforma y se valida
| Lugar | Valida | Transforma |
|---|---|---|
| Gateway | Token, scope de la ruta, tamaño, tipo de contenido | Nada |
| Servicio de dominio | Esquema del contrato, pertenencia del recurso al partner, políticas de canal, reglas de negocio | Contrato externo a modelo canónico |
| Adaptador | Datos que llegan del legado (rangos, nulos, duplicados) | Modelo canónico a formato del legado y viceversa. Es el único lugar donde existe el formato del legado |
| Productor de eventos | Esquema del evento antes de publicar | Nada |
Trade-off: la validación del esquema ocurre dentro del servicio, un salto después del gateway, así que una petición mal formada consume un poco más de recursos antes de rechazarse. A cambio el gateway no conoce el negocio y cada equipo es dueño de su contrato.
3.6 Decisión clave 4: versionado de APIs
- Versión mayor en la ruta (
/v1). Solo cambia ante una ruptura. - Los cambios compatibles (campos nuevos opcionales, endpoints nuevos) no cambian versión. Los clientes deben ignorar campos desconocidos.
- Una ruptura publica
/v2y/v1convive al menos 6 meses, con cabecerasDeprecationySunset. - Regla de diseño, con su comprobación aún sin implementar (F4, sección 3.8): el pipeline comparará el contrato contra la rama principal y bloqueará rupturas no declaradas, es decir, eliminar o renombrar un campo de respuesta, agregar un campo obligatorio a una petición o cambiar el tipo o el significado de un campo. Hoy el pipeline valida el formato de los contratos (lint) y la comparación se hace en revisión.
- Eventos: mismo criterio. Evolución compatible dentro del tópico; una ruptura crea un tópico
.v2.
Se descartaron la versión por cabecera o por tipo de contenido (más difícil de probar, enrutar y explicar a un partner) y la versión por fecha (útil con muchos cambios pequeños; aquí sobra). Trade-off: la versión en la ruta invita a duplicar código al llegar /v2; se mitiga traduciendo /v1 a /v2 en el borde del servicio.
3.7 Disponibilidad 99.9%
99.9% al mes son 43 minutos de indisponibilidad permitida. Consecuencias de diseño:
- Ninguna API externa depende en línea del enlace on-prem ni de ERP, WMS, OMS o CRM.
- Tres zonas de disponibilidad (centros de datos independientes de una misma región de AWS) para EKS, PostgreSQL, Redis y Kafka.
- Si Redis falla, las lecturas caen a la base del servicio con concurrencia limitada.
- Si un legado cae, las lecturas siguen con el último dato y lo marcan como desactualizado; las órdenes se siguen aceptando contra las reservas de la capa.
Trade-off: la capa pasa a ser crítica. Si cae, caen todos los canales a la vez (riesgo R2); por eso las tres zonas y el presupuesto de error con alertas (sección 7).
3.8 Cómo se impide que la arquitectura se degrade
Cada requisito no funcional tiene una función de aptitud (fitness function: prueba automática que protege una característica de la arquitectura mientras el sistema cambia). Son el criterio de aceptación de cada requisito, no documentación. No todas tienen hoy el mismo estado, y la tabla lo dice con tres niveles: compuerta hoy (corre en el pipeline en cada cambio, con make verify), prueba ejecutable, sin compuerta (existe y pasa cuando se corre a mano, y entra al pipeline según el roadmap, sección 8.3) y diseño, sin implementar (la función está definida y no hay verificador).
| # | Requisito | Función de aptitud | Estado hoy |
|---|---|---|---|
| F1 | p95 menor a 300 ms en stock y precio | Prueba de carga con umbral | Prueba ejecutable, sin compuerta: make f3-e2e |
| F2 | No tumbar ERP ni WMS | En el pico 10x, las llamadas al legado no superan la línea base más 10% | Prueba ejecutable, sin compuerta: make f3-e2e |
| F3 | Agregar sistemas con mínimo impacto | Regla de dependencias: solo los adaptadores importan clientes del legado; los servicios de dominio no se llaman por REST entre sí | Diseño, sin implementar: ninguna herramienta la comprueba. Se verificó a mano que hoy se cumple (los únicos clientes HTTP o gRPC de los servicios son el de la pasarela, el de entrega a partners y el de order a inventory) |
| F4 | Evolución y versionado | Comparación de contratos que bloquea rupturas | Diseño, sin implementar. Hoy make verify solo valida el formato de los tres contratos (lint), no compara contra la rama principal |
| F5 | Seguridad consistente | Ninguna ruta del gateway sin scope declarado | Compuerta hoy: gateway-verify, dentro de make verify |
| F6 | Auditoría de punta a punta | Una orden de prueba deja su correlationId en cada servicio y en cada evento |
Prueba ejecutable, sin compuerta: make f4-e2e comprueba los logs de los cinco componentes; los eventos y la auditoría no se comprueban de punta a punta |
| F7 | Multi-tenant | Un partner no puede leer la orden de otro; un partner que excede su cuota no afecta a otro | Prueba ejecutable, sin compuerta: make f4-e2e (aislamiento de órdenes) y make mesh-kind-test (cuota) |
| F8 | Manejo de datos personales | Ningún dato personal de la orden de prueba aparece en logs, eventos ni trazas | Prueba ejecutable, sin compuerta: make f4-e2e revisa los logs de los servicios y del borde; eventos y trazas no se revisan automáticamente |
| F9 | Idempotencia | La misma orden enviada 5 veces en paralelo crea una sola orden y una sola reserva | Prueba ejecutable, sin compuerta: make f4-e2e |
| F10 | Resiliencia | Con el ERP caído, stock y precio responden 200 | Prueba ejecutable, sin compuerta: make f3-e2e |
El pipeline de hoy corre make verify (formato de contratos, gateway, secretos, redacción, versiones, infraestructura y malla sin clúster), make smoke y make edge-test. Las pruebas de comportamiento de F1, F2 y F6 a F10 necesitan todas las piezas corriendo y por eso se ejecutan aparte; llevarlas al pipeline es parte del roadmap (sección 8.3), igual que construir F3 y F4.
Trade-off: cada función de aptitud es código que mantener y tiempo de pipeline. Por eso son pocas, concretas y ejecutables.
3.9 Despliegue y red del demo en AWS
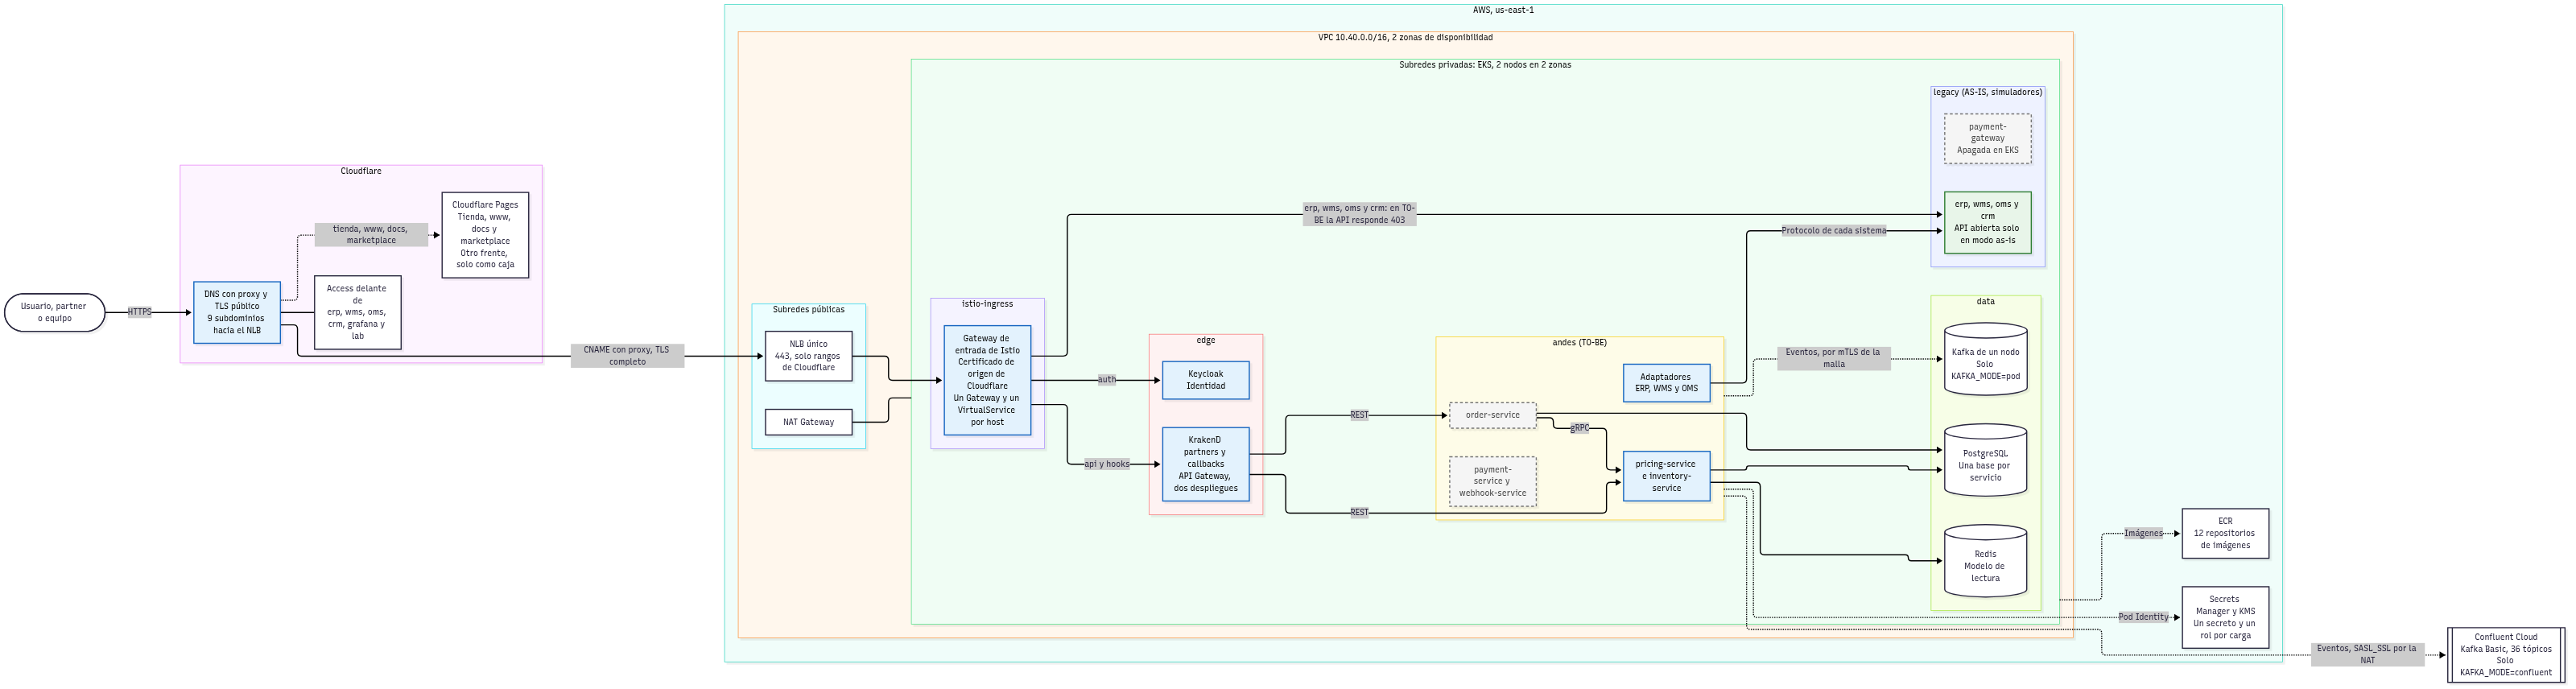
El demo corre en AWS (región us-east-1) detrás de Cloudflare. Cloudflare pone el DNS con proxy, el TLS público y Cloudflare Access (control de acceso por correo) delante de erp, wms, oms, crm, grafana y lab; api, hooks y auth quedan abiertos porque los protege el token. Un solo balanceador de red (NLB, Network Load Balancer, el balanceador de AWS) acepta únicamente los rangos de Cloudflare en el puerto 443 y entrega al gateway de entrada de Istio, que enruta por host con un Gateway y un VirtualService de Istio por subdominio (networking.istio.io/v1; no se usa la Gateway API de Kubernetes en este demo, ADR-030): api y hooks a KrakenD, auth a Keycloak, y erp, wms, oms y crm directo a los simuladores. Dentro del clúster (EKS, dos nodos en dos zonas, subredes privadas) hay cinco espacios de nombres: istio-ingress, edge, andes (la capa, TO-BE), legacy (los sistemas de hoy, simulados, AS-IS) y data (PostgreSQL y Redis). La única llamada síncrona interna es el gRPC de order-service a inventory-service. Kafka depende de un interruptor (ADR-028): en un pod de data para desarrollo, ensayos y respaldo, o Confluent Cloud, fuera del clúster, al que las cargas llegan por la NAT (Network Address Translation: la salida a internet de las subredes privadas). Cada carga lee su secreto de Secrets Manager con un rol de Pod Identity; las imágenes salen de ECR (Elastic Container Registry, el registro de imágenes de AWS). La tienda, www, docs y marketplace están en Cloudflare Pages y son de otro frente; aquí solo aparecen como caja.
La tienda de demostración, el canal de comercio electrónico del demo, está publicada en andesretail.com (un Worker de Cloudflare), con un aviso de que es una demostración. Quedó conectada a la capa en EKS el 15/11/2026: sus lecturas de precio y stock salen de la capa, con la hora del dato y el aviso de dato desactualizado cuando el stock llega stale. La compra de punta a punta en el dominio publicado, con la tarjeta de prueba de Stripe, queda por probar por Andrés; la tienda no guarda datos de pago, que van a la pasarela.
Lo AS-IS y lo TO-BE conviven en el mismo clúster: los subdominios de los sistemas tienen su ruta de API abierta solo en modo as-is; en modo to-be responde 403 y solo su adaptador la llama, por dentro. La API de Kubernetes del clúster no está en internet: el endpoint es solo privado y se entra por un túnel (sección 5.8, ADR-027).
Kafka para los ensayos: el ADR-028, ampliado el 15/11/2026 por el ADR-034: Kafka en pod y Confluent Cloud quedan los dos arriba y un comando cambia a cuál se conectan las cargas (195 s de pod a Confluent y 28 s de vuelta, medidos). La capa corre en Confluent Cloud Basic (una zona, us-east-1, 36 tópicos) desde el 15/11/2026. La decisión original del 14/11/2026 es correr Kafka en un pod dentro del clúster para desarrollo y pruebas, y usar Confluent Cloud del 15 al 17/11, hasta la presentación, con el pod de respaldo. El cambio es un interruptor de configuración (KAFKA_MODE, pod o confluent), sin tocar código ni contratos; el diagrama muestra los dos modos. Registro: ADR-028 (anexo D).
Estado real al 15/11/2026. En AWS está aplicada la base de la cuenta (secretos, repositorios de imágenes, llaves de KMS y presupuestos), que cuesta 0,29 dólares por día y queda siempre. El 14/11/2026 el clúster se encendió una sola vez, de 17:07 a 19:32 UTC (2 h 25 min), para desplegar los simuladores del legado y medir el AS-IS en la nube (sección 6.8); se apagó con make infra-off y make infra-audit confirmó que no queda clúster, nodos, NAT, balanceador, discos ni IP elásticas del demo. El 15/11/2026 el clúster se volvió a encender con la capa TO-BE completa, la malla de Istio, el DNS (Cloudflare en modo Full strict y Access con PIN) y Kafka en Confluent Cloud, y se midieron en EKS los seis escenarios (sección 6.8). Además, desde el 15/11/2026 el despliegue a EKS (make k8s-eks-deploy) aplica la malla con sus salidas declaradas hacia Kafka en Confluent Cloud, la pasarela de pagos, KMS y el agente de Pod Identity, que las políticas de salida restringida (REGISTRY_ONLY) bloquearían sin declarar; el ingress de auth ya no deja alcanzar la consola de administración de Keycloak. La prueba del borde en EKS (EDGE_ENV=eks node tests/k8s/edge-e2e.mjs) dio 20 de 20 contra Confluent: token por auth, stock, precio y orden por api, y la orden llega a CONFIRMED por la saga. Defecto abierto a esa fecha: los consumidores de wms-adapter y oms-adapter se crean sin SASL_SSL, así que con Confluent el stock sale marcado stale y la orden se confirma sin registrarse en el OMS; con Kafka en pod no ocurre (ADR-034). Las piezas con borde discontinuo en el diagrama son diseño y no corren todavía.